本文由 简悦 SimpRead 转码, 原文地址 www.zhihu.com
要是我真的在知乎研究抖音 PYMK(People You May Know)算法的逻辑,不仅容易被字节的算法大佬脸打肿,还会因为话题不热乎吃不到知乎给的流量。
所以这一次,我要写:
如何避免伴侣通过 “可能认识的人” 找到你的出轨对象。
在抖音的社交图谱中,每个用户都是图谱里的一个节点。这个节点记录着用户的各项特征,维度多达 100 至 150 维 [1]
,完完整整地覆盖所有偏好类型。
两个用户间,如果产生了显性或者隐性的互动,抖音就会在这两个用户的节点间,悄悄连上一条线,也就是所谓的边(Edge)[2]
。边的权重和时间,决定了这段关系的强弱和新鲜度 [3]
。
21 年的时候,抖音好友推荐的社交图谱中就有了 15 亿个节点和 2500 亿条边 [4]
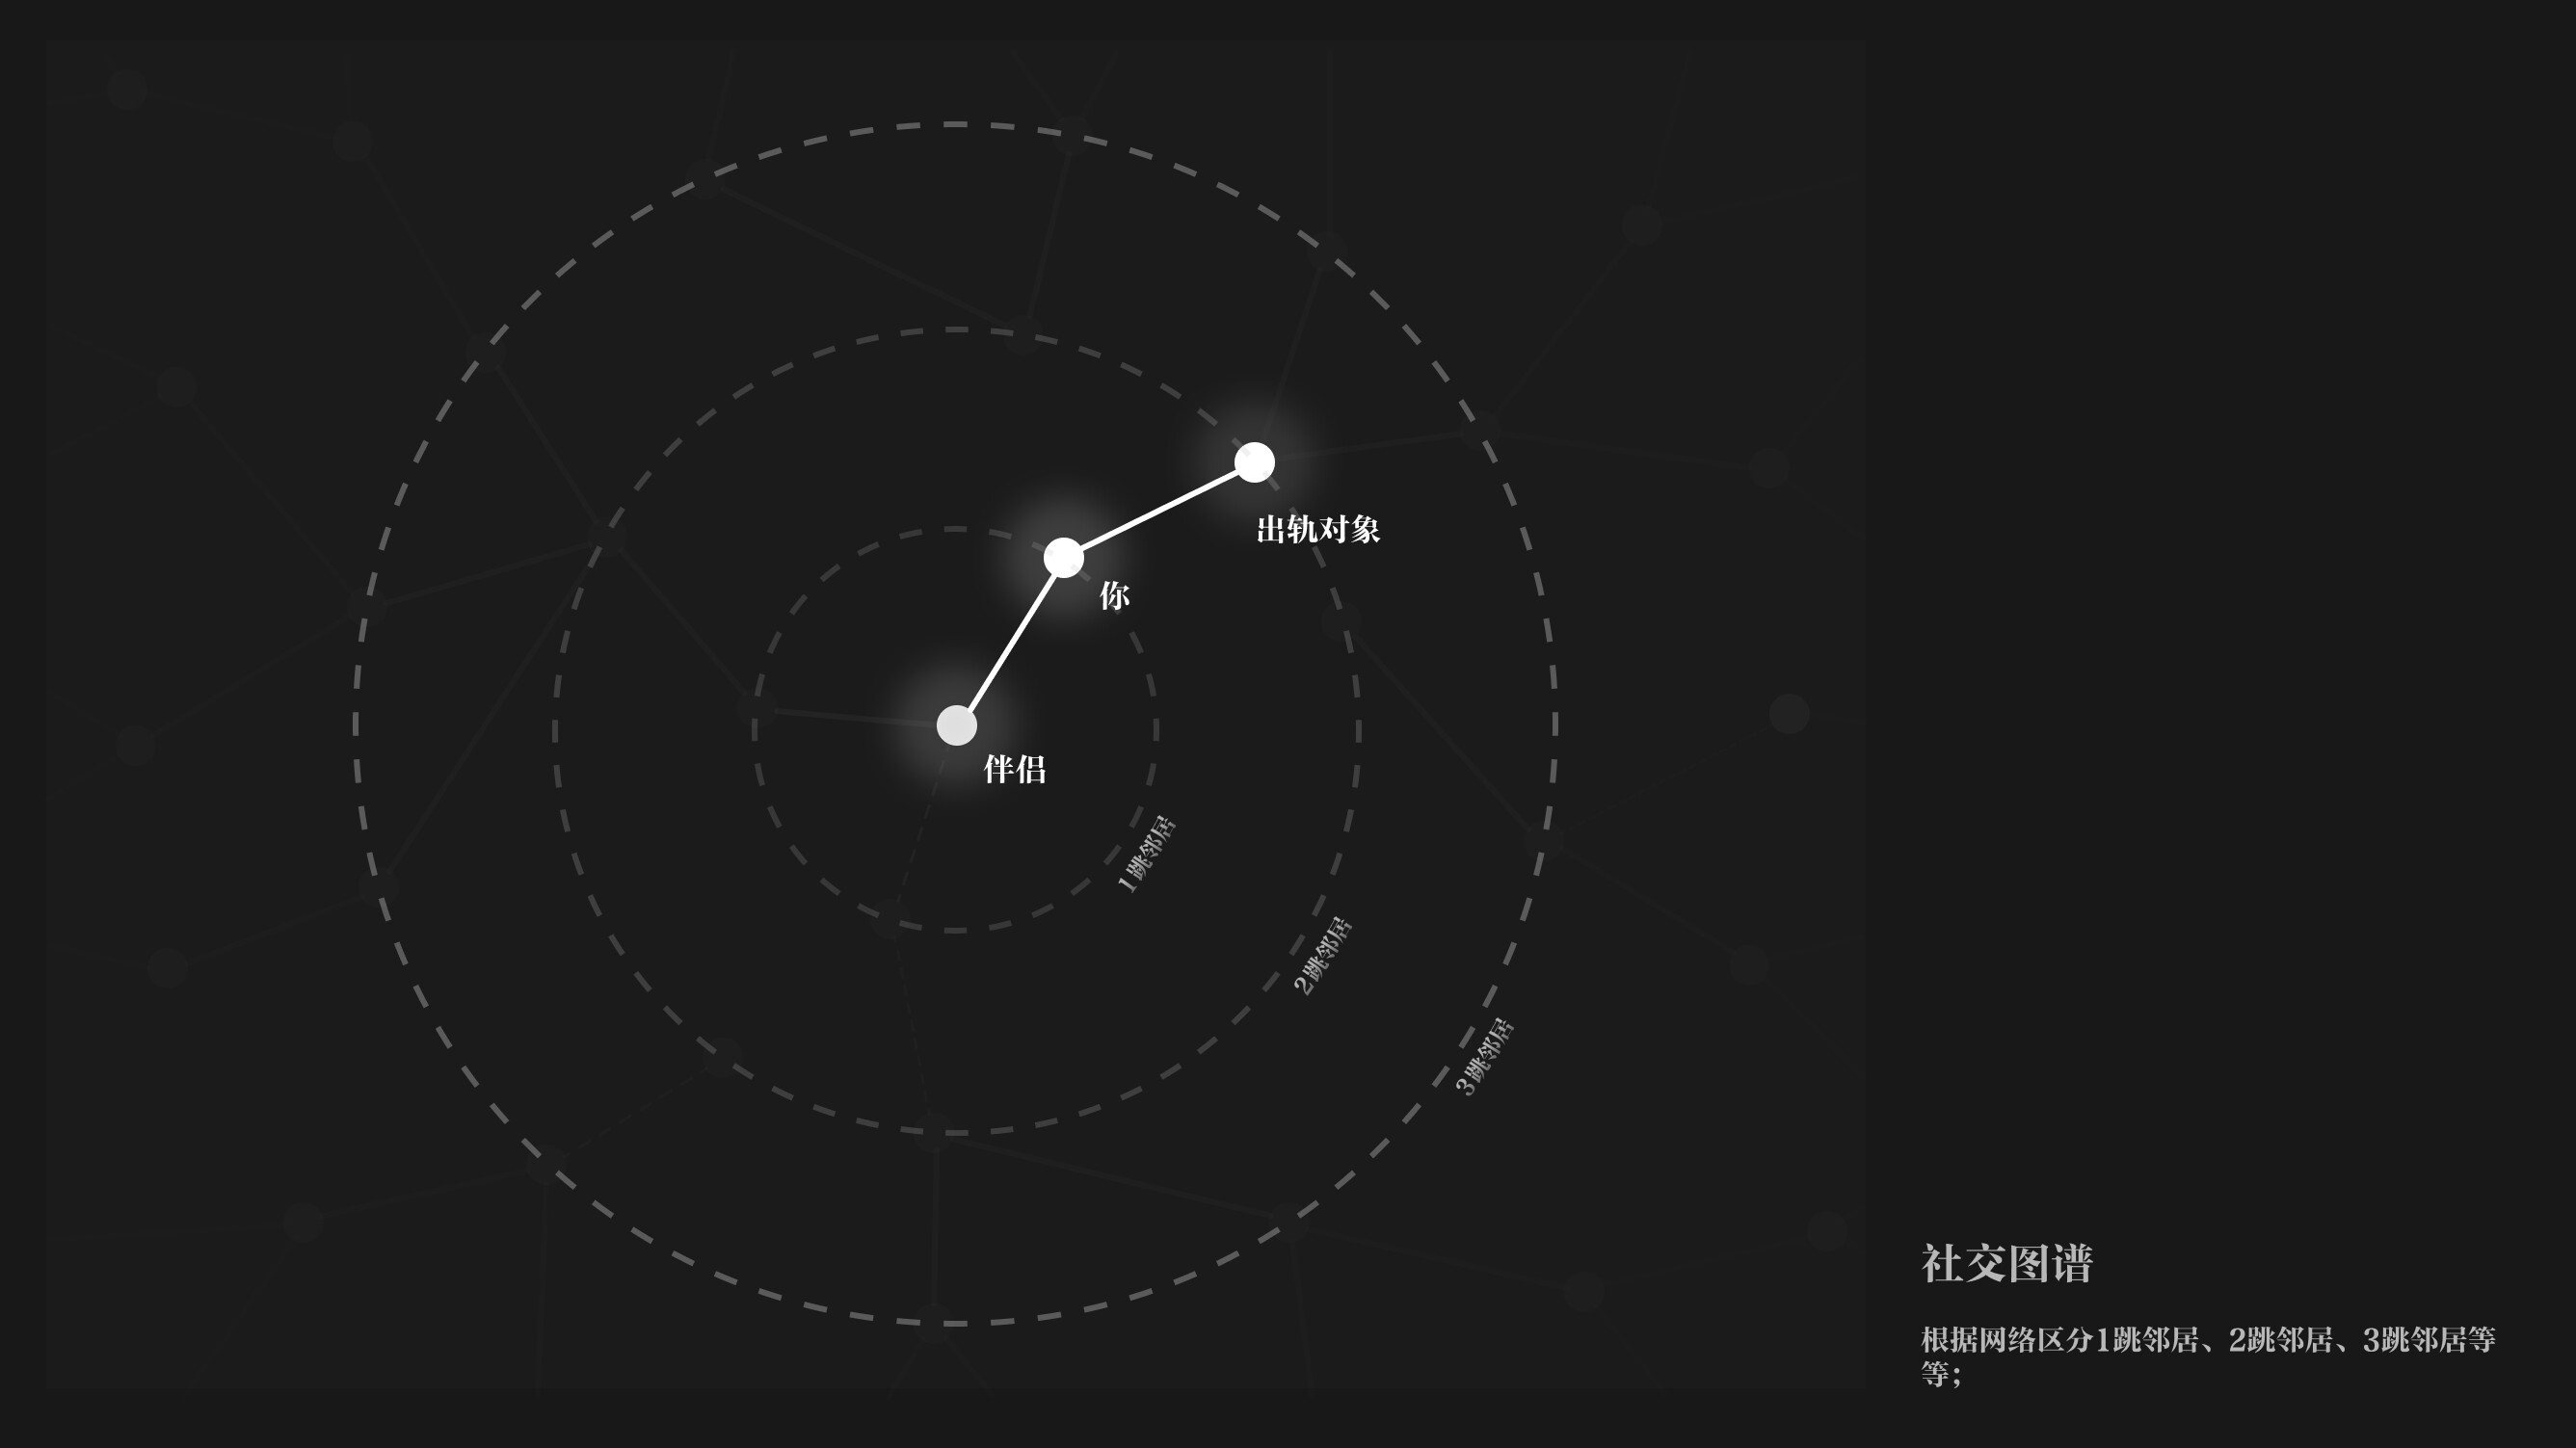
,这些点和边在一起构成了一个巨大的网格。从你的节点出发,沿着网格,直接连着你的节点就是 1 跳邻居,顺着这个邻居可以继续找到 2 跳邻居、3 跳邻居——当抖音想要向你推荐可能认识的人时,就会从这些圈定的邻居中,评估你真正可能认识的人。
抖音评估的逻辑有两种。
第一种比较暴力直接,按节点顺藤摸瓜往下搜查 [5]
。
由于你和你伴侣必然是 1 跳邻居,如果你和你的出轨对象也保持 1 跳邻居,那你伴侣的抖音就极容易顺着你找到你的出轨对象——所以,首先要做的就是终止你们的 1 跳强关系 [6]
。
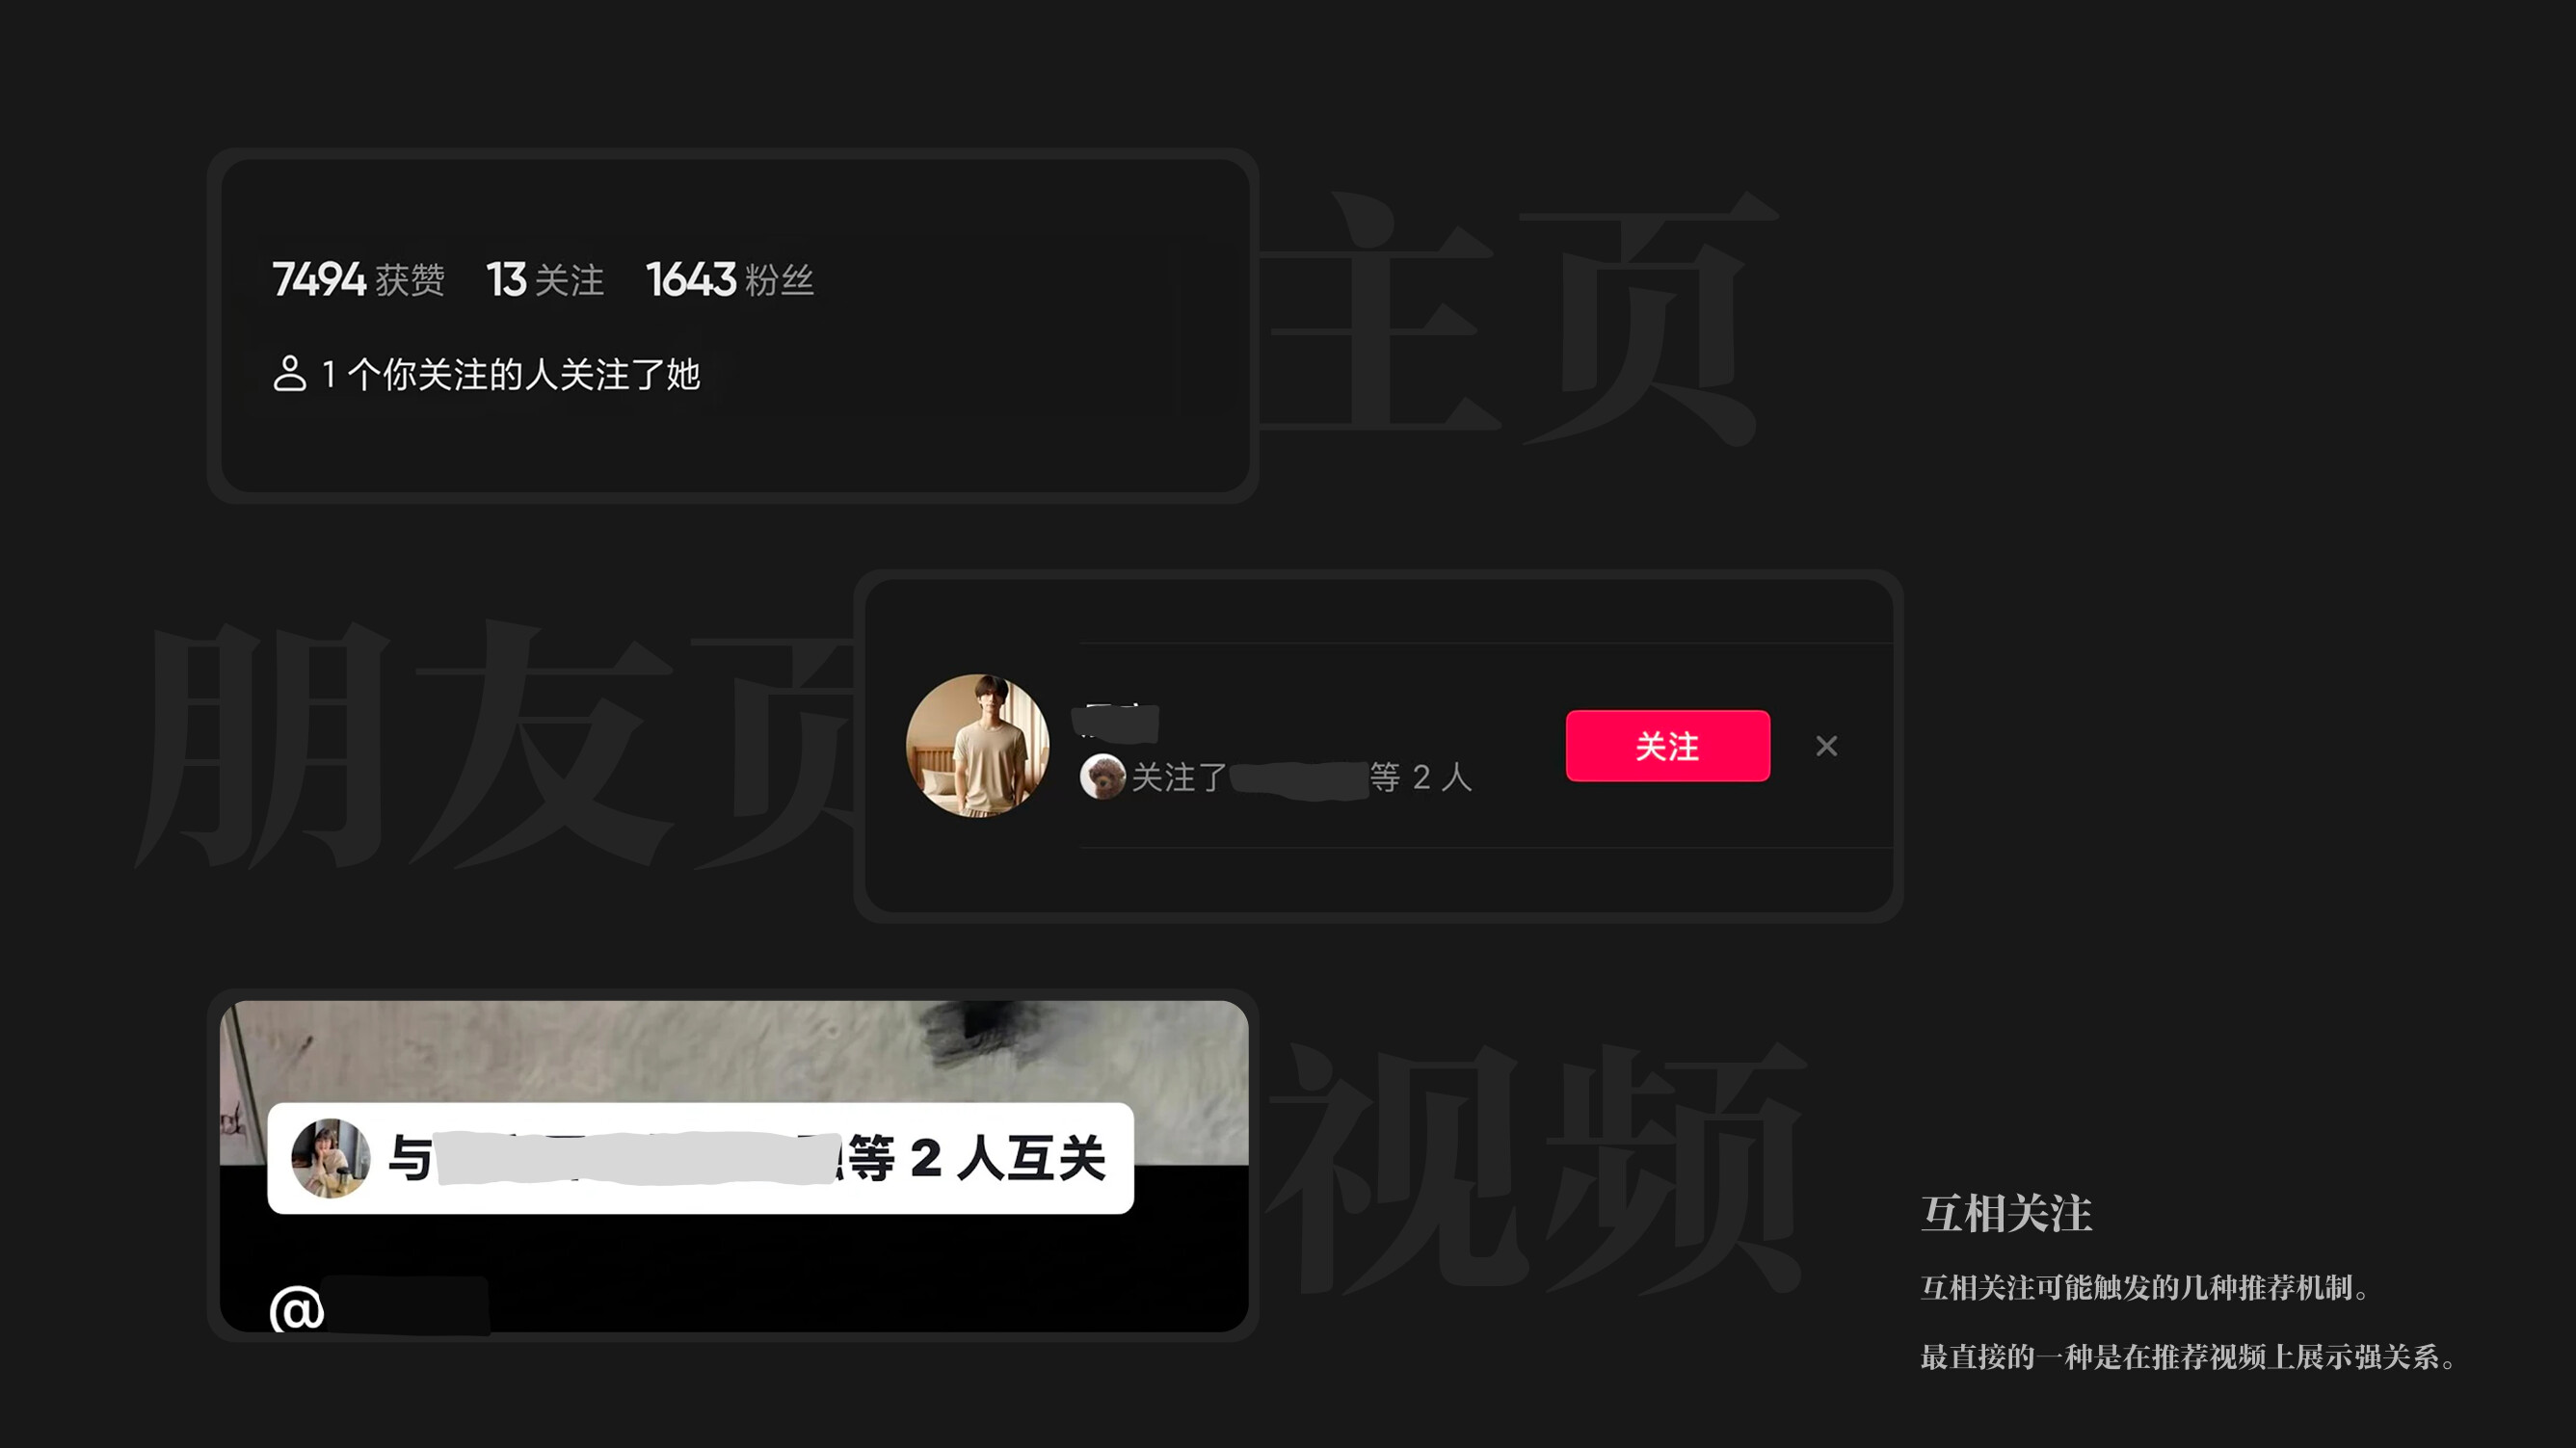
① 互相关注
取关是基操。
抖音最爱干的,就是提示你,1 个你关注的人关注了他(她)。现在甚至会在推荐的视频里带上你的头像,显示 “与 @xx 等人互关”。
保持互关简直就是往你伴侣的抖音上贴脸做推荐,不仅极大地不尊重出轨这件事情,还亵渎了出轨的隐秘性。
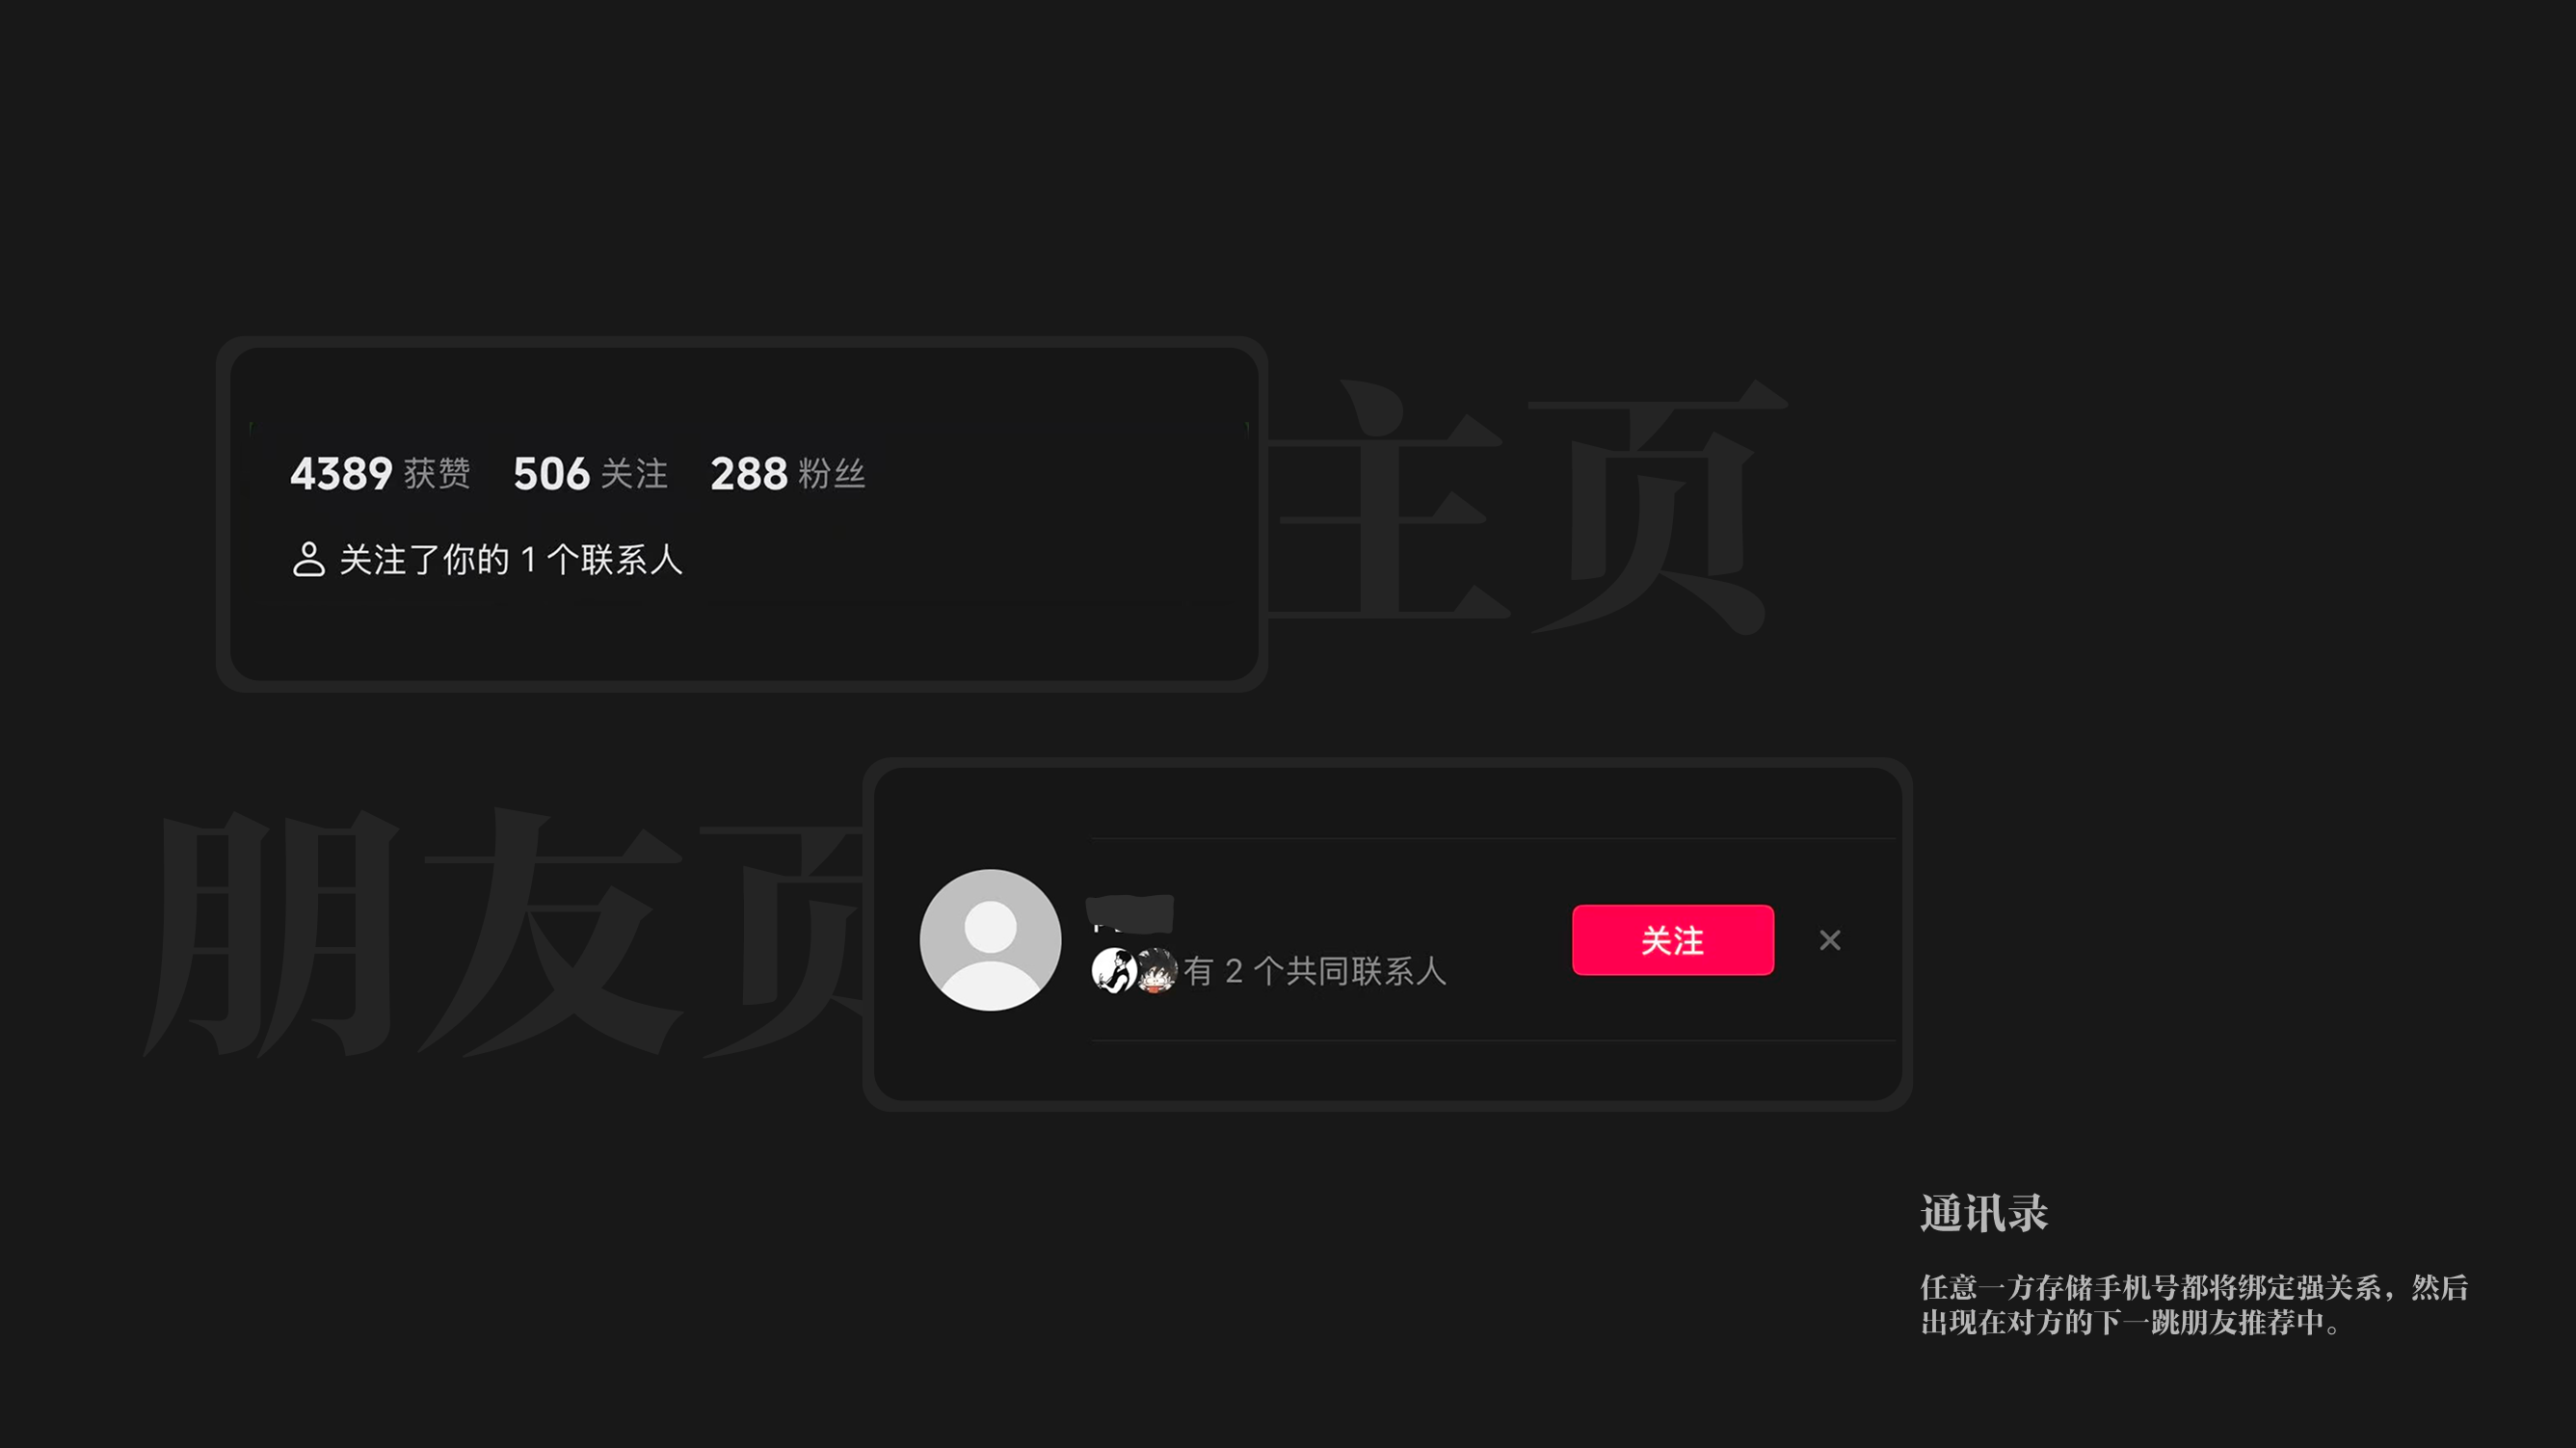
② 通讯录
接着,关闭抖音的通讯录授权。
通讯录几乎是在明明白白地告诉抖音,这是费心记载的一度人脉(在可能认识的人列表里,甚至可以通过头像查看是谁的联系人)——抖音不仅识别你的通讯录,如果你出轨对象的通讯录里如果有你,也会直接建立起确定的 1 跳强关系。
③ 分享行为
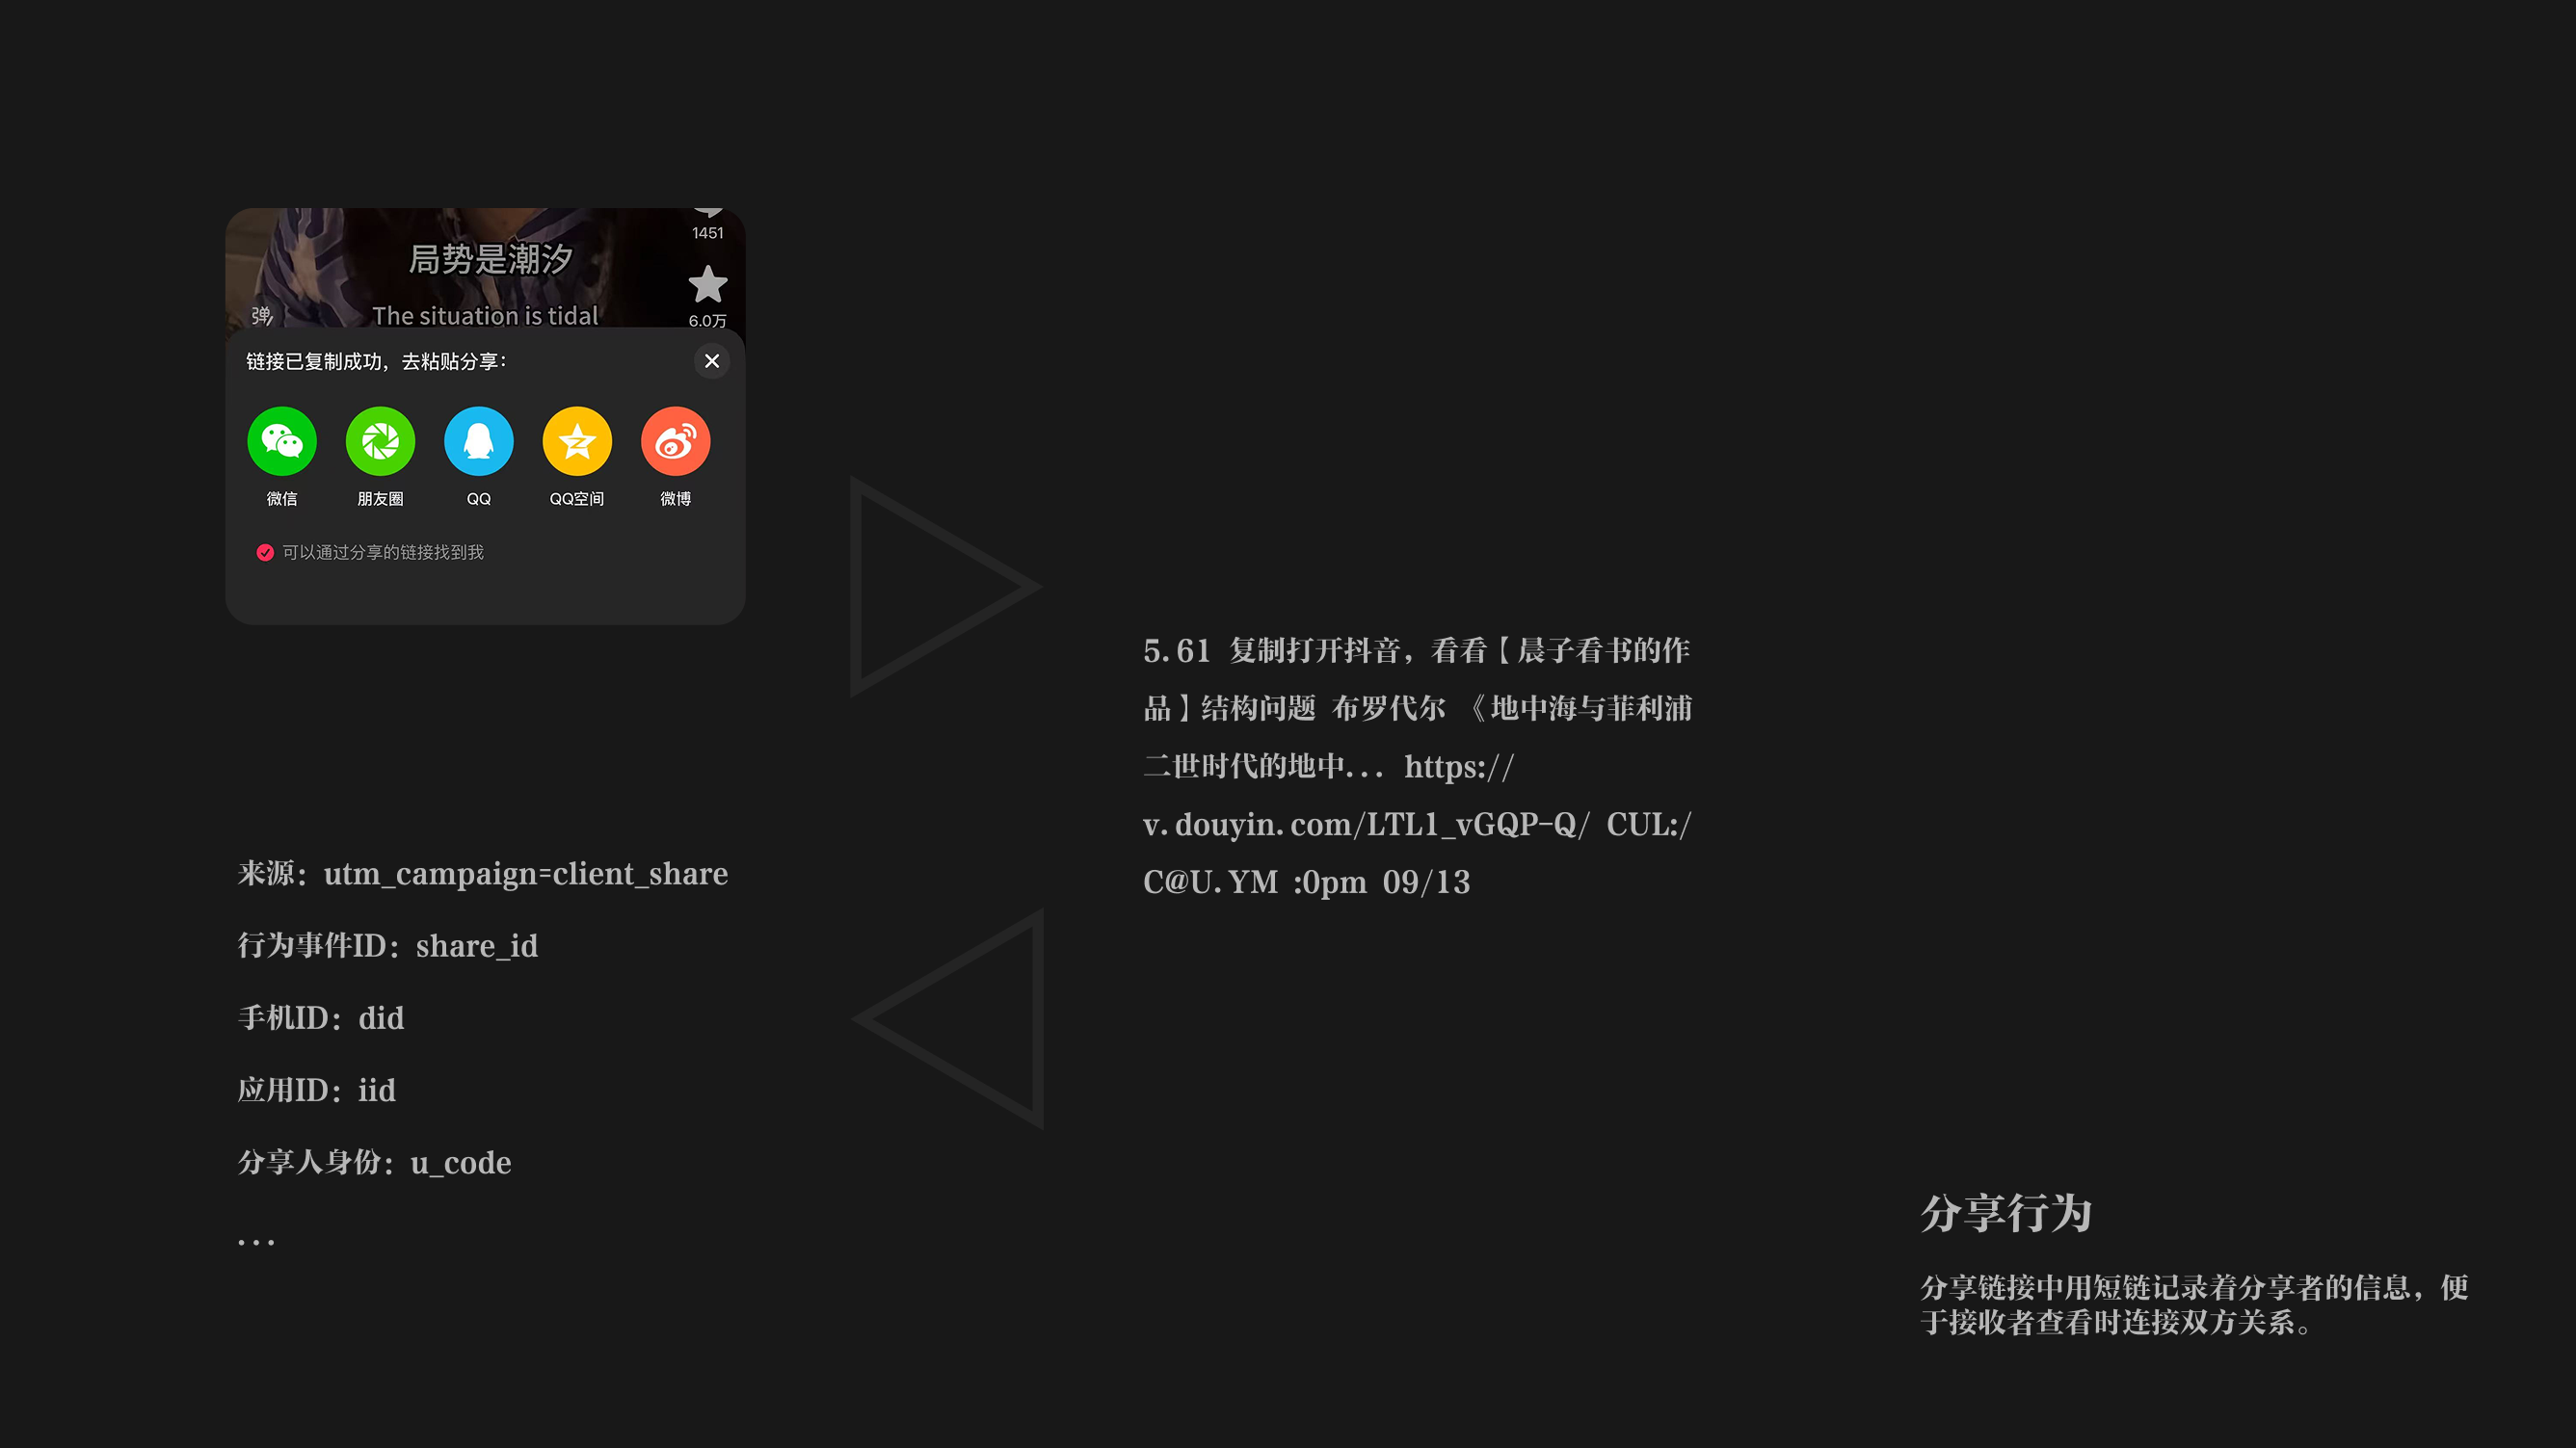
这是相对隐蔽,但能直接挖掘关系的一种方式。
当你在微信上分享抖音的链接时,这个链接上保持着你的各项 ID 参数。将这个链接复制到抖音查看分享内容时,系统会将双方的账号进行强关联。分享查看得越多,越能确定互相真实关系越不一般。
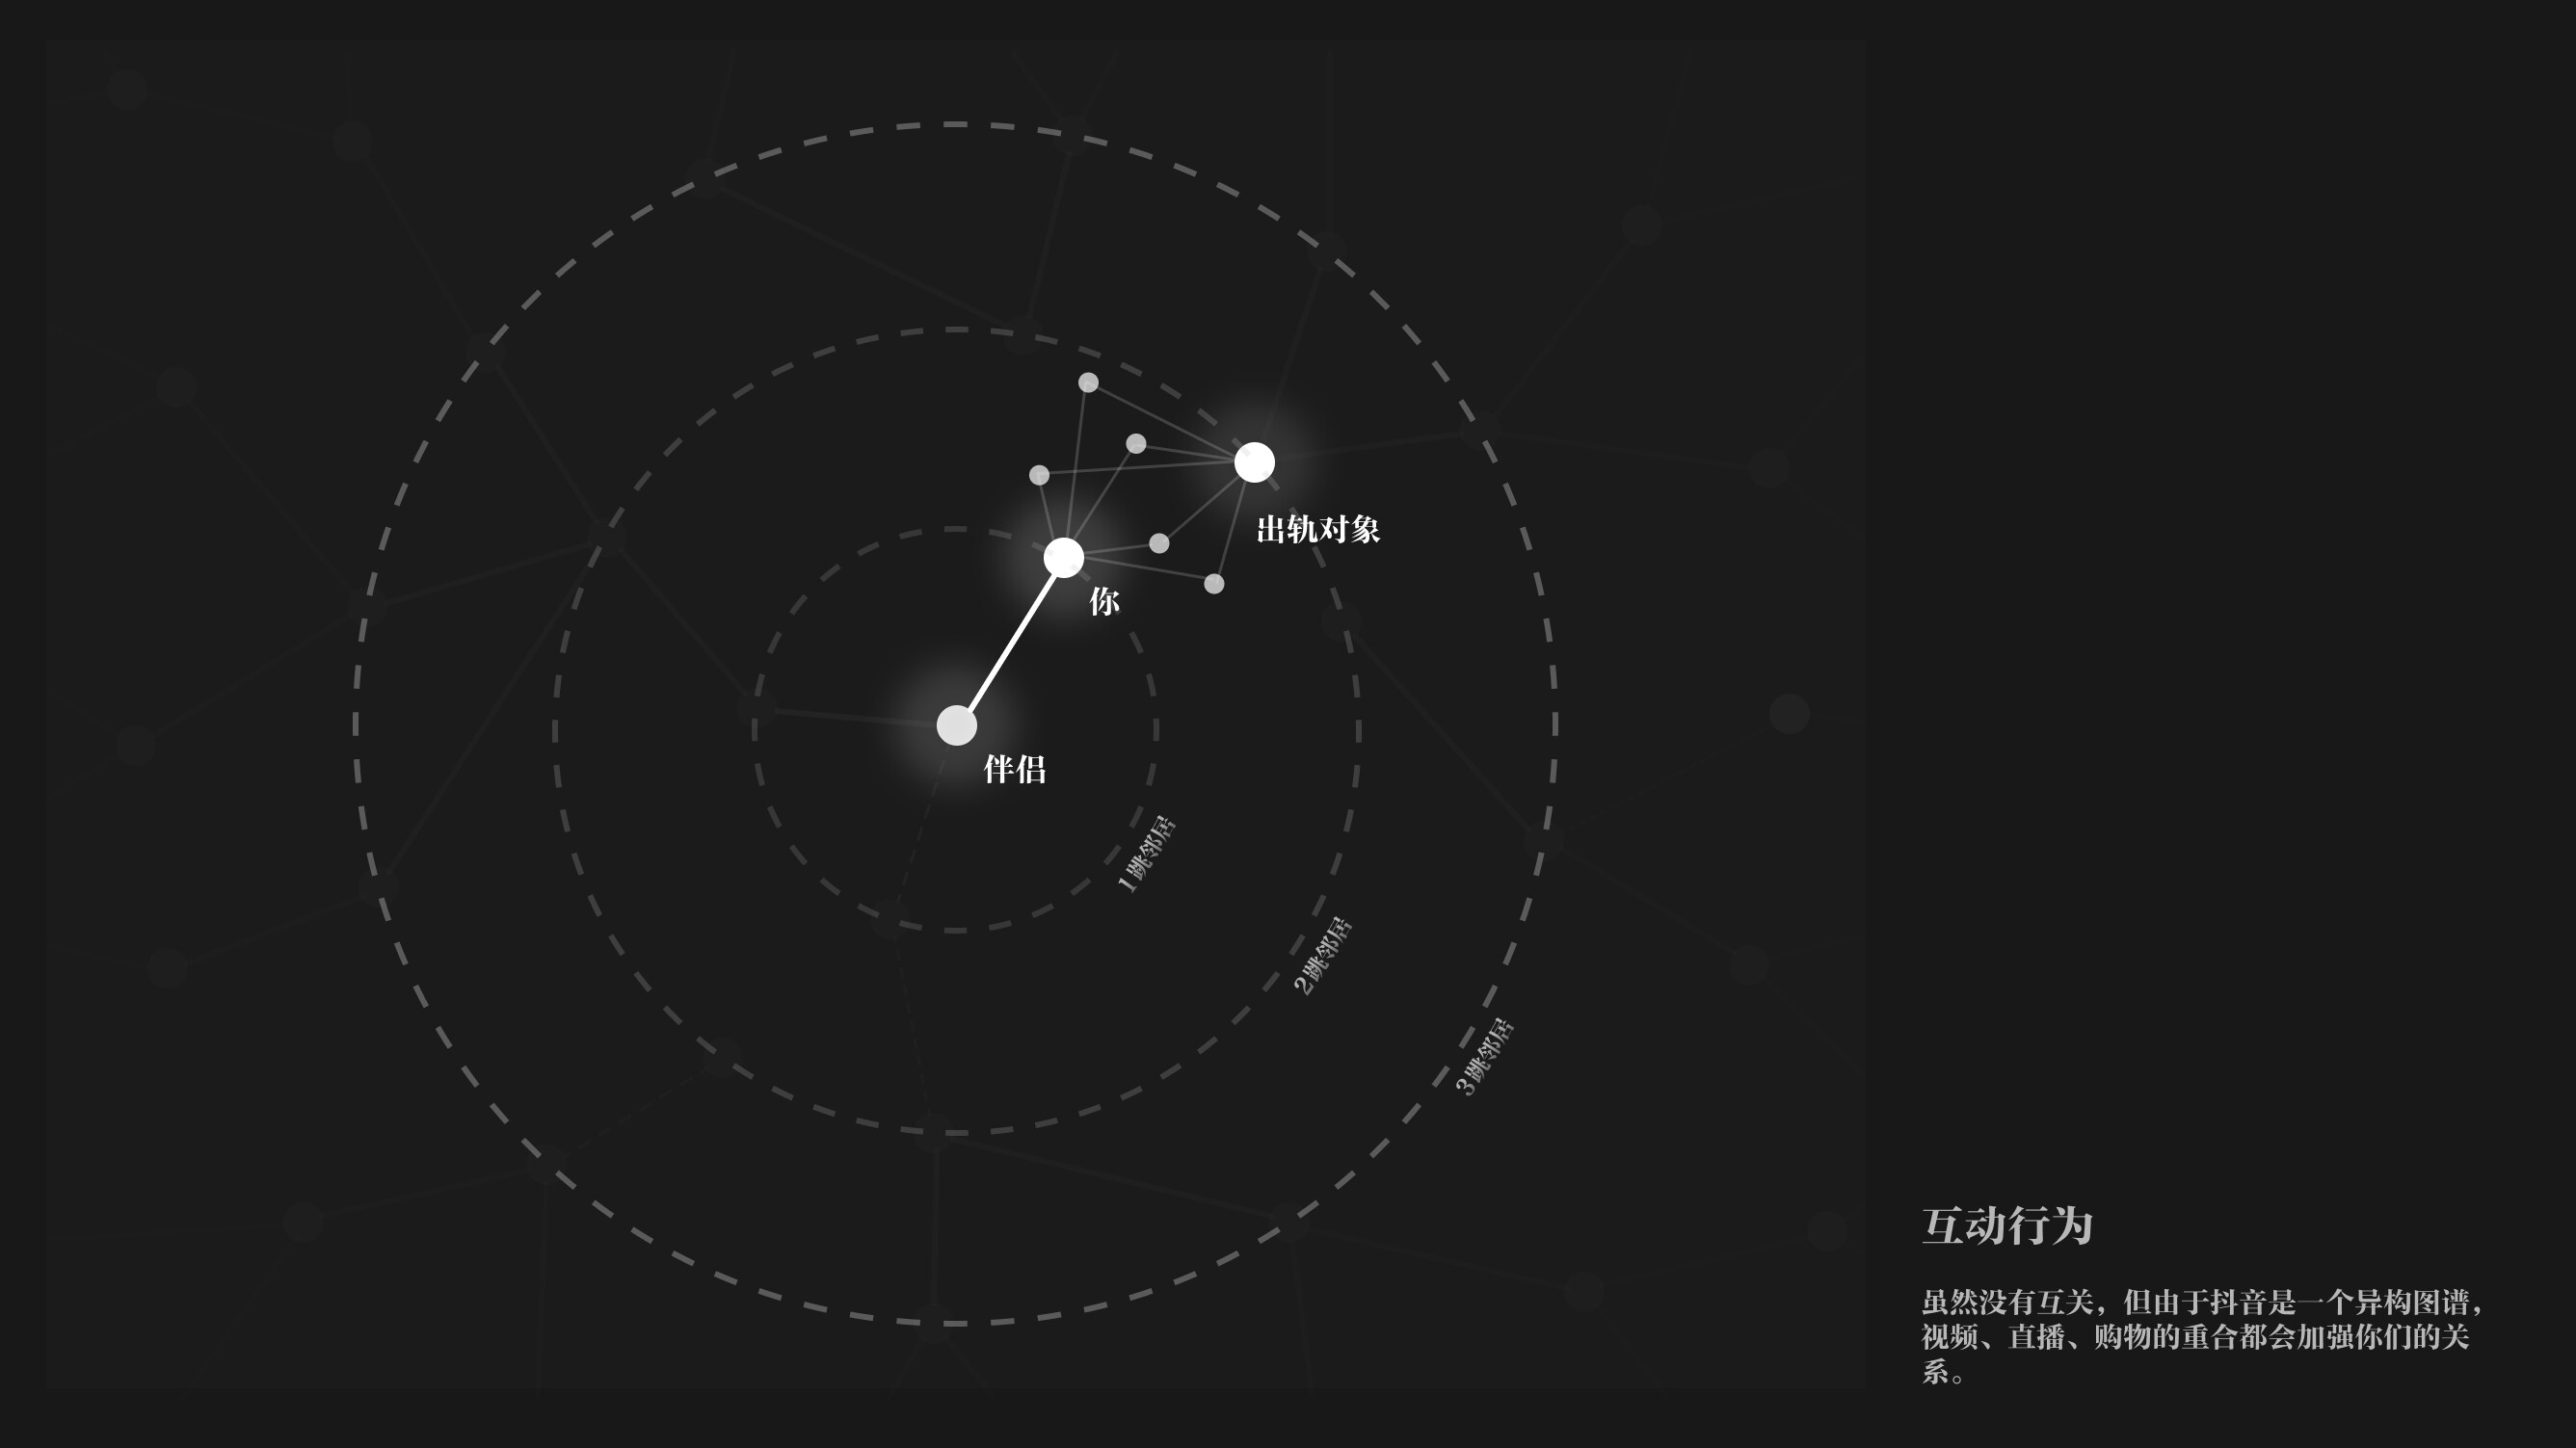
④ 同类互动
和分享类似,如果账号互访主页,或者同一时间里对某个小众的视频内容有着相同的点赞和收藏行为,那抖音就会判断这些账号较大的概率是线下互相认识的熟人 [7]
。
当你们经常共同给冷门餐厅、小众旅游地的视频点赞或收藏,或者在同一个直播间里互动,越是创造独特美好回忆,越容易让抖音给你们连上一条隐性的强边 [8]
。
⑤ 地理位置
这几乎是最难避免的方式——如果你们长期连着相同的 WiFi、BSSID、蓝牙或基站,时空轨迹总是重合,那必然代表着你们是关联度极强的线下伙伴。
除了关闭位置权限,我还劝你最好不要和出轨对象待在一起。
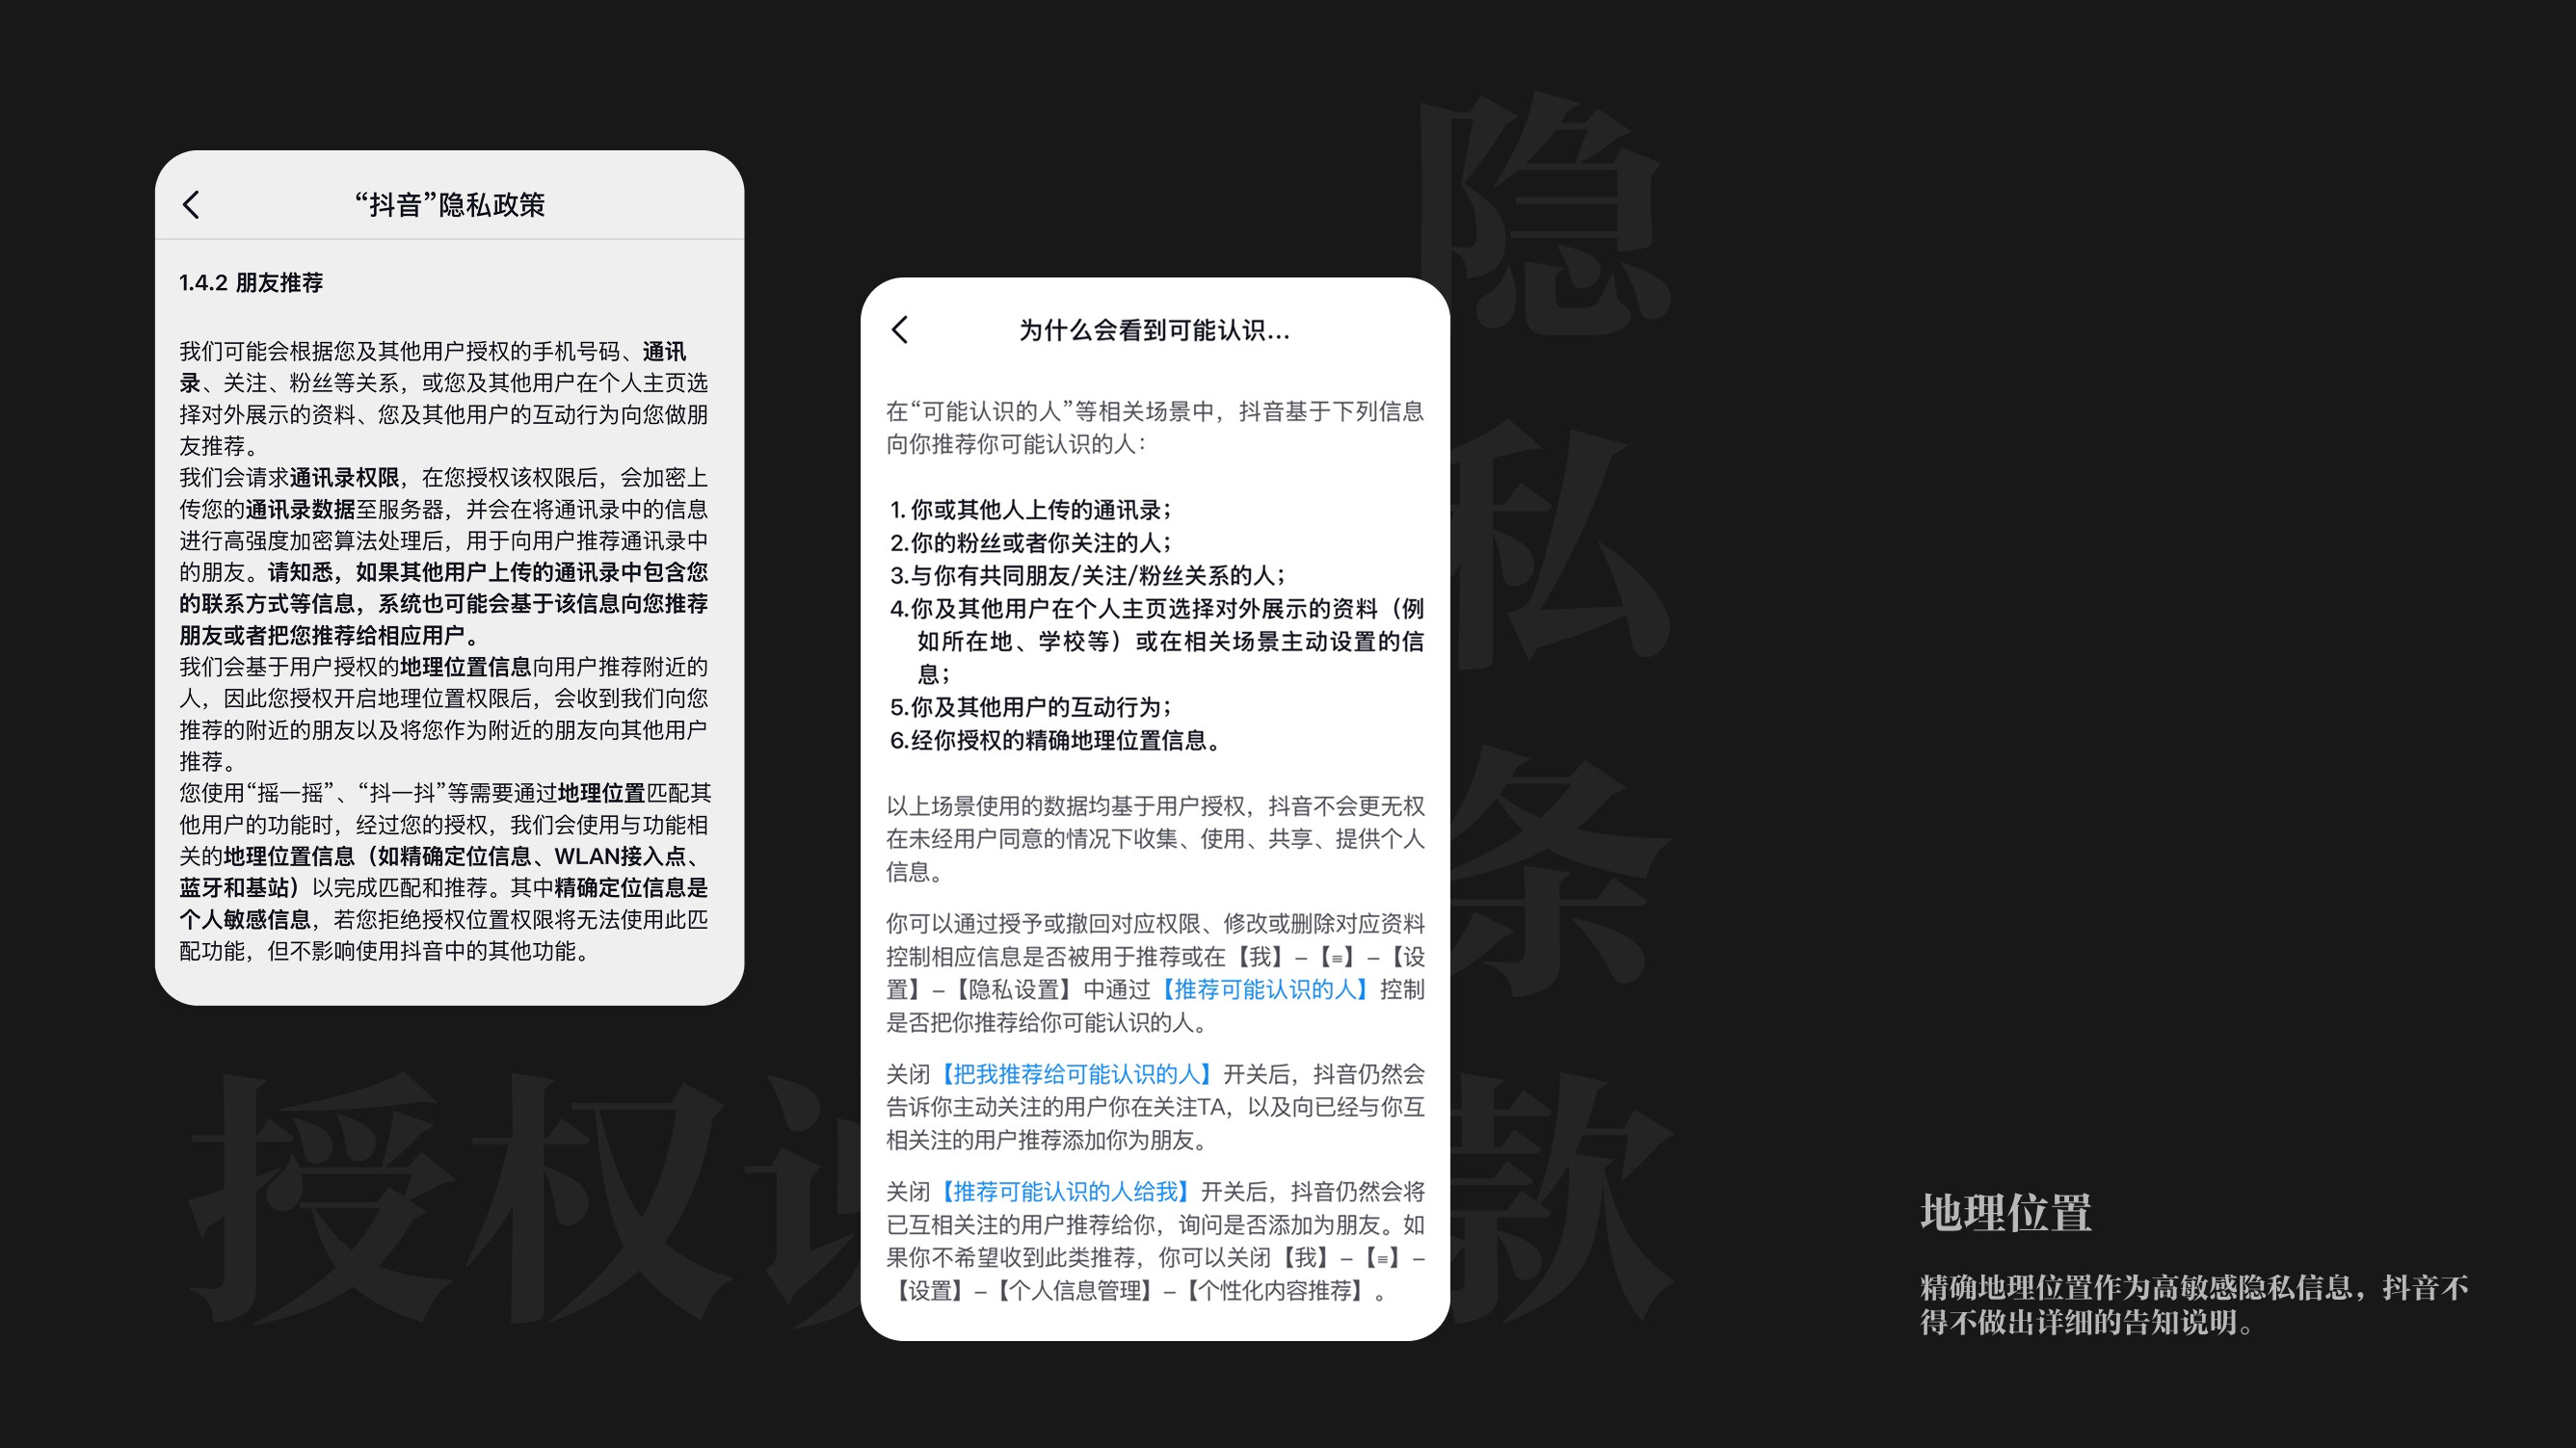
这些今天我们都很熟悉的方式,就是抖音推荐可能认识的人的基础逻辑。
你可能会想,如果让你的出轨对象关闭【把我推荐给可能认识的人】,是否就可以避免暴露呢?
当然不是了,你还是小瞧了抖音 is watching you 的威力。
这个开关只能避免出轨对象直接出现在你伴侣的【朋友推荐卡片】列表中。由于抖音的视频推荐流和好友推荐是共用一套底层图谱和跨域异构图(CDG)[10]
,所以你的出轨对象依旧有可能出现在伴侣刷到的视频里。
如果你平时留意到自己常常刷到一些低赞视频,打起精神来,虽然没有【可能认识的人】的标签,但抖音又在发力,给你推荐可能认识的人了。
这就引申出抖音评估的第二种方式,图神经网络(GNN)。
社交这件事,就是带有强烈的圈层属性的——只需要将环绕你的社交圈,集合在一起,就能提炼出一个能代表你的专属社交坐标(向量)。再拿着你的坐标和其他人进行比对,越相似,你们认识的概率也就越大。
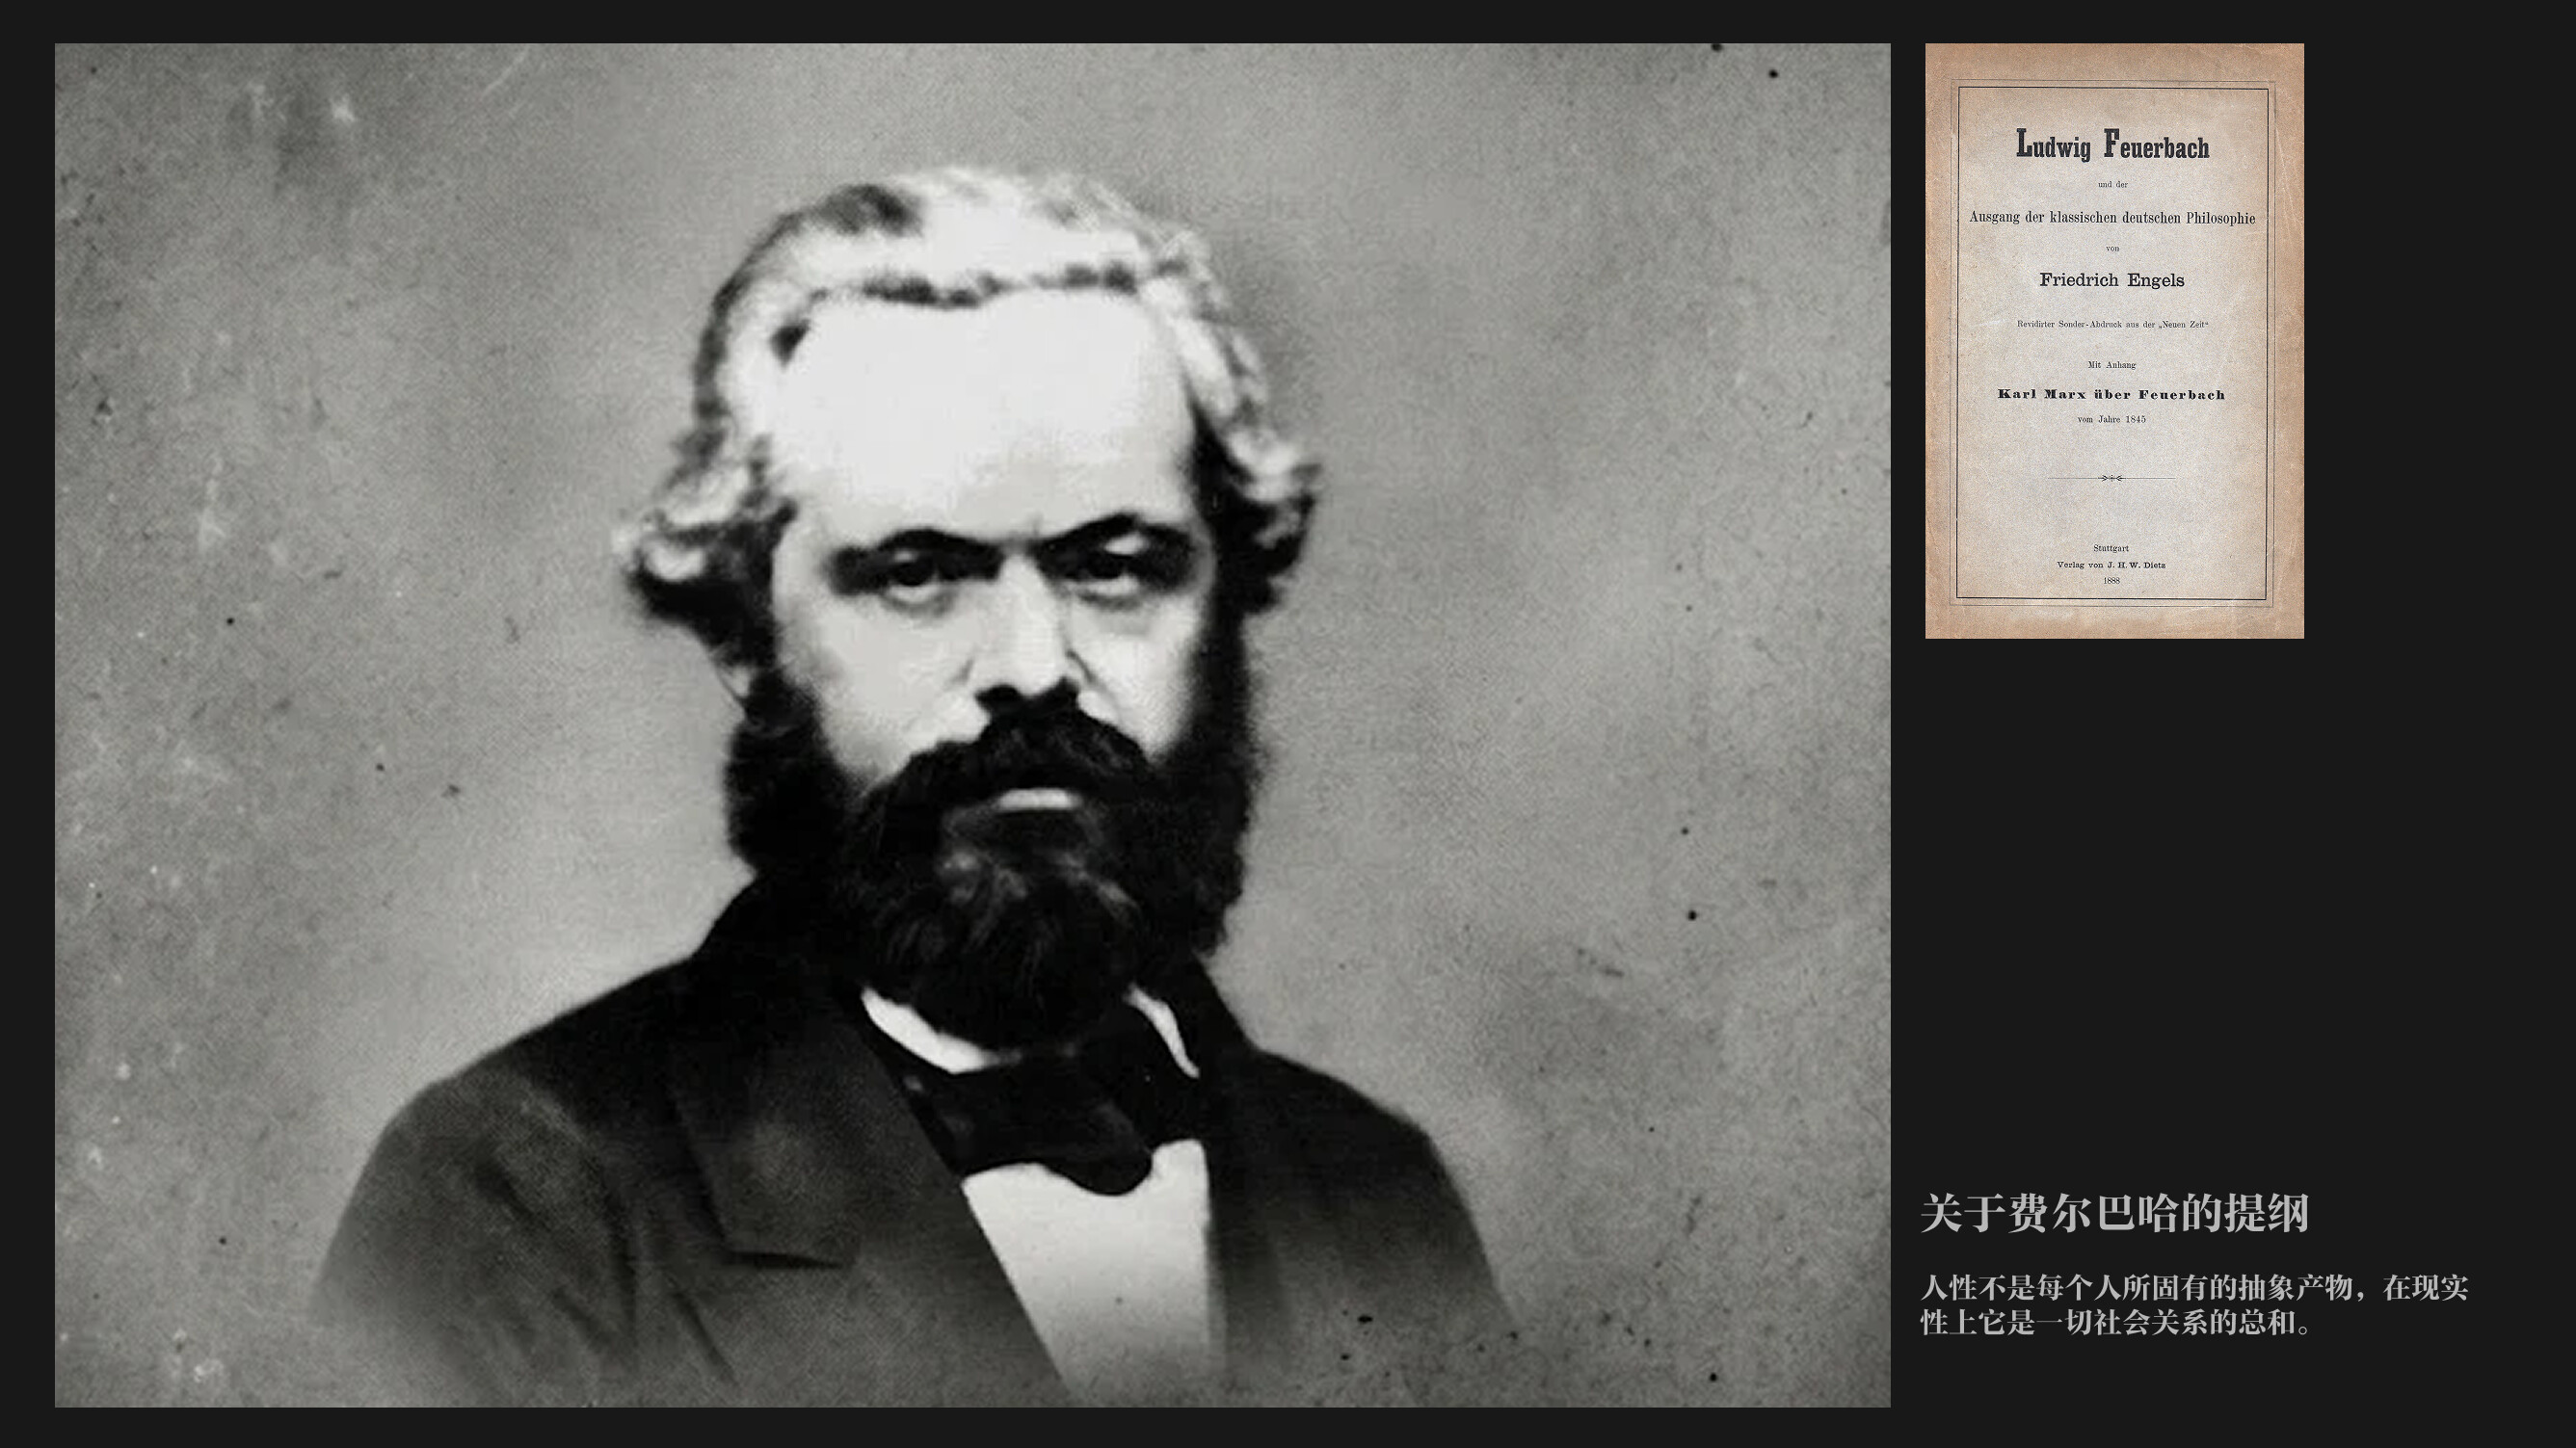
就像马克思说的,人性不是每个人所固有的抽象产物,在现实性上它是一切社会关系的总和。
抖音实测后发现,提炼 2-3 跳邻居时向量准确率达到了最高。一旦扩展到 4-5 跳,由于噪声过多,准确度就会开始下降 [11]。
所以,我们的朋友的朋友,或许确实能够决定我们是一个什么样的人。
那怎么提炼你的社交坐标(向量)呢?
抖音训练了一个图推荐模型,可以将每个用户提炼成 256 维的社交坐标(向量)。这个模型借鉴了大语言模型训练时的掩码方案(也就是完形填空)——先把你 1-3 跳的数百位邻居列出来,然后每一跳里故意隐藏其中的几个,逼着模型通过你和你剩下的邻居们,猜出被遮住的好友有哪些特征。
由于空间图结构上做了自回归预测,所以字节直接将这个模型命名为 Spatial Autoregressive Coding,简称 SAC。
在经过极多的历史经验数据的毒打后,这个模型不仅越来越狠辣,还有了这几个显著的特点:
① 小团体烙印
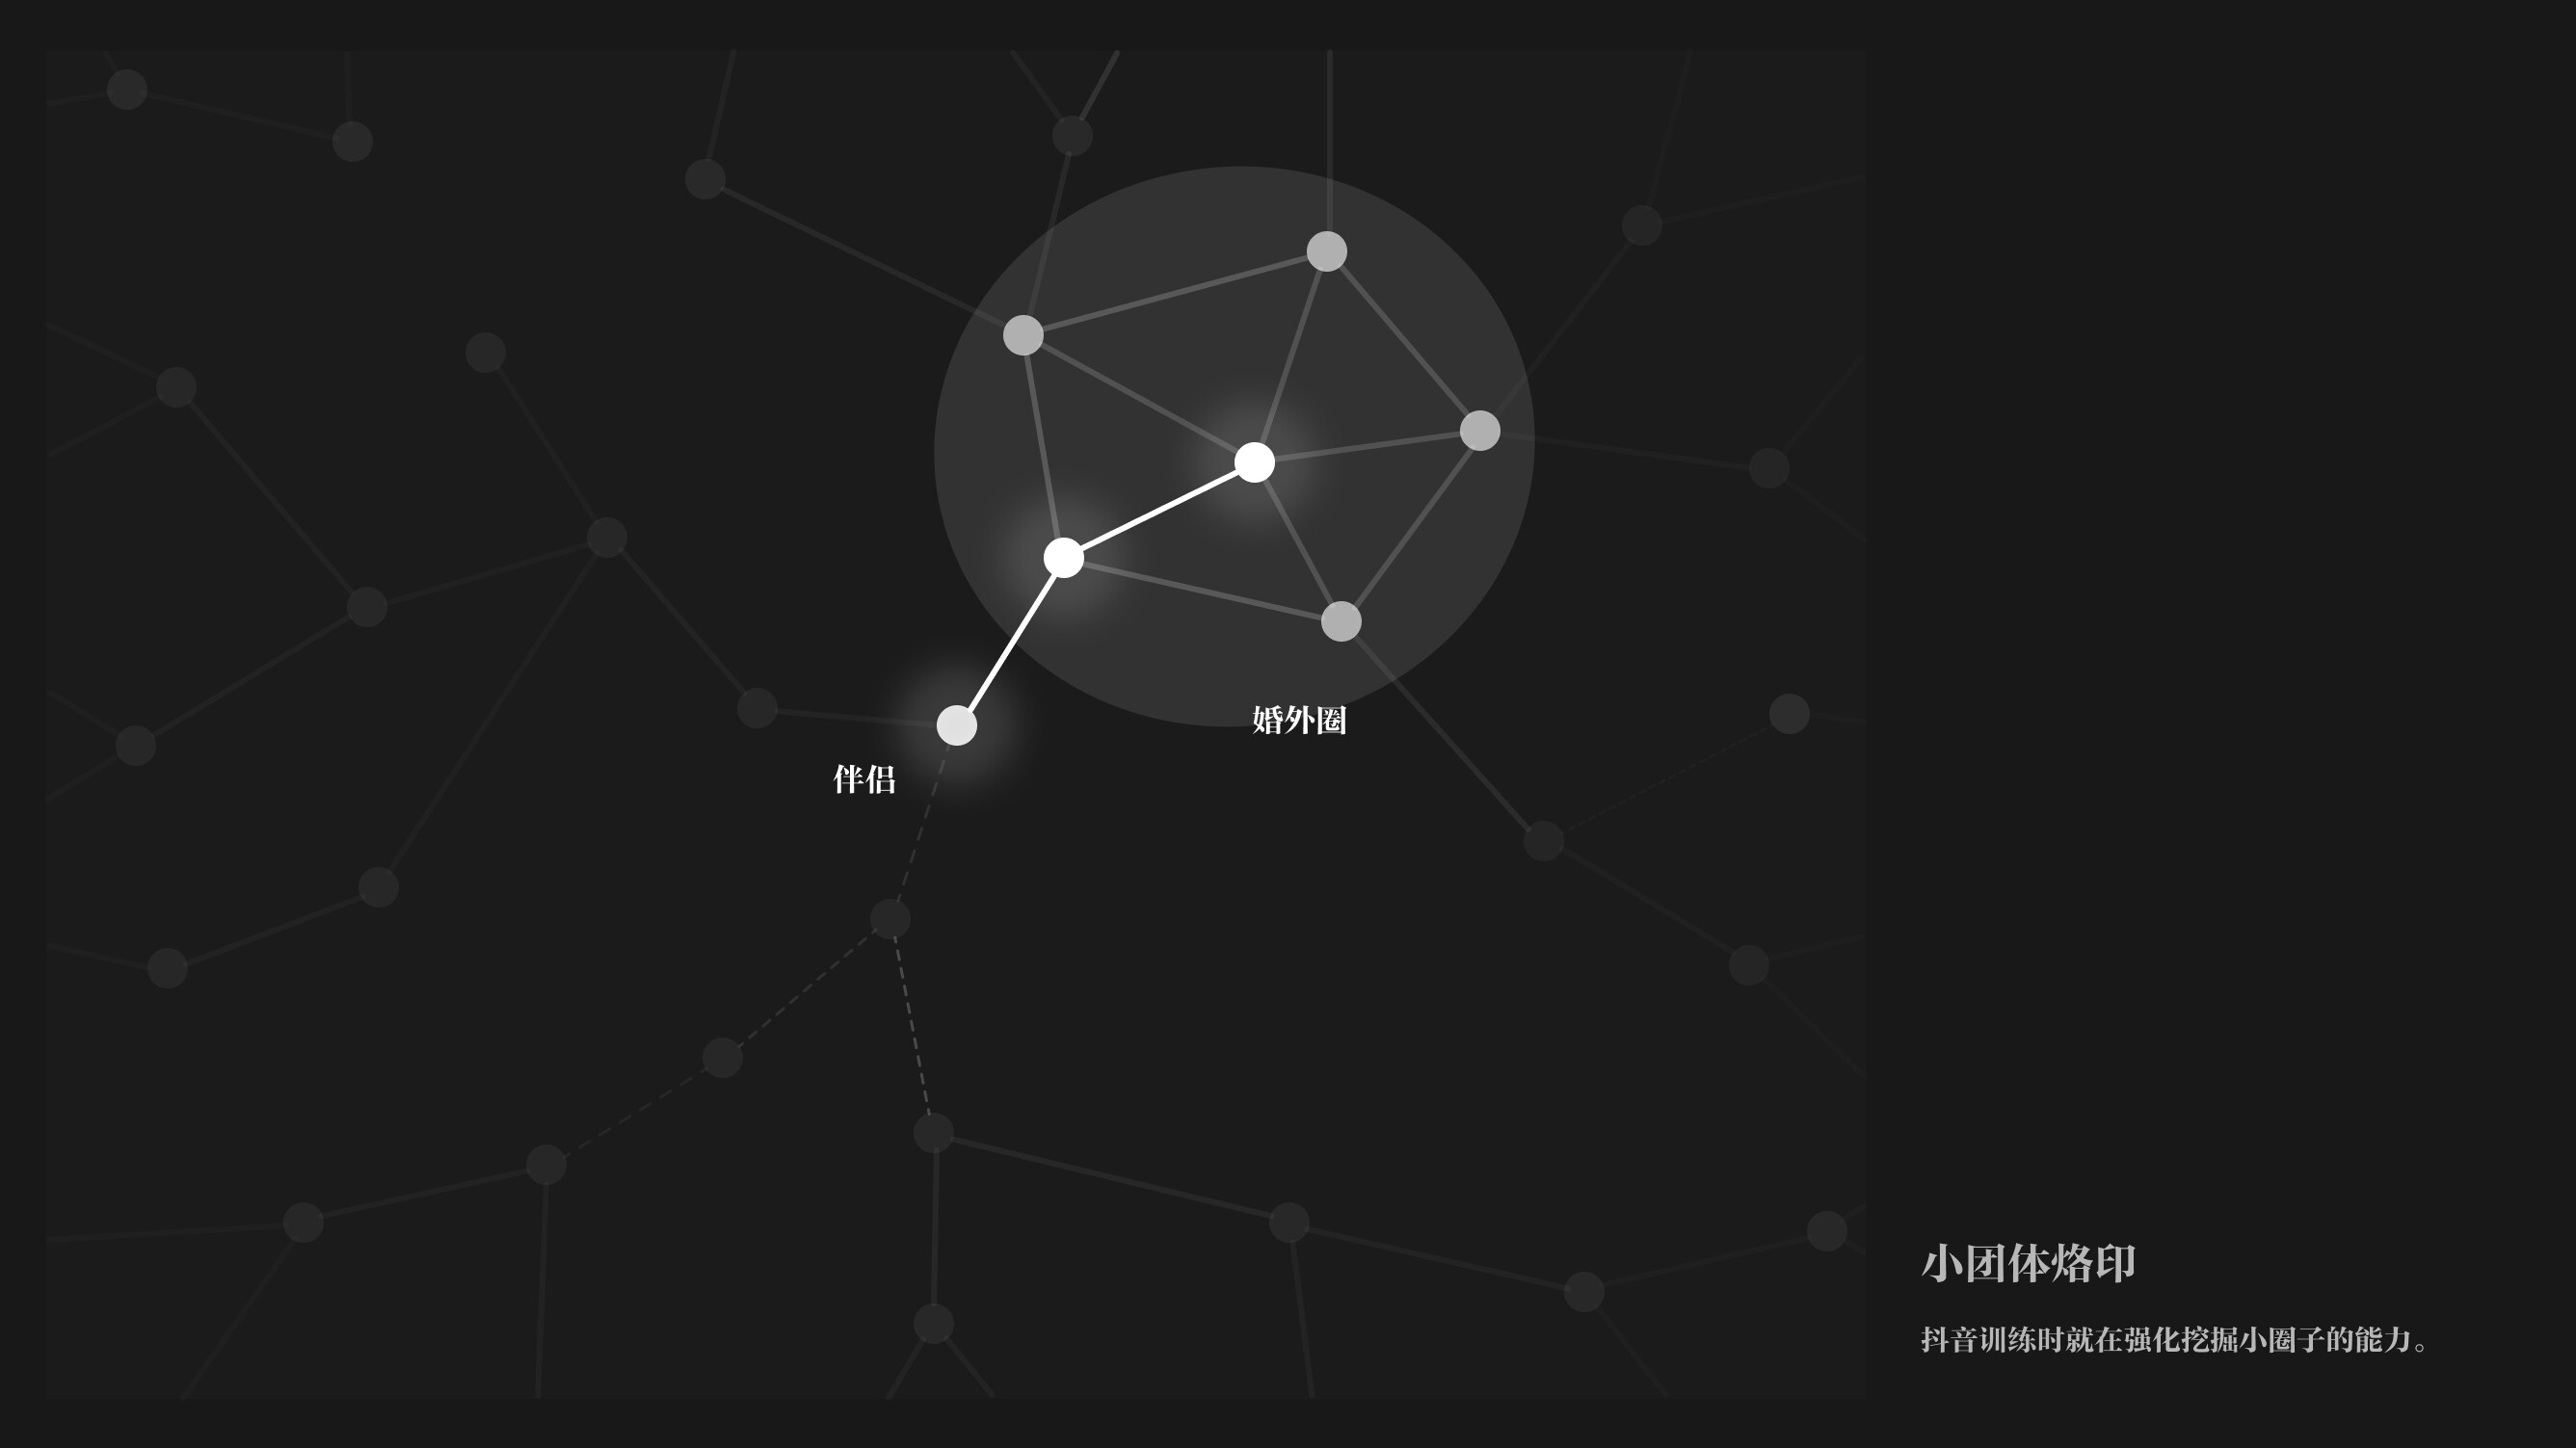
模型在训练时,是直接对比用户和 1-3 跳邻居之间的关系——如果判断用户和这些邻居之间存在某种强相关特征,就会将这个特征直接记录在用户的社交向量中。
训练采用了 2 层 Transformer 架构,在第 1 层运行中,如果用户 2~3 跳里的邻居有人同属于一个圈子,就会先通过自注意力机制形成带有 “小团体属性” 的新特征;到了第 2 层运行时,这个 “小团体” 特征会被重重地烙印进用户的社交向量里 [12]
。
这就意味着,抖音这个模型,更偏向在群体间找新关系。只要用户的朋友有一个固定的小团体,抖音就会一起打包,把小团体的成员成批拽进推荐列表里。
因此,不要认识任何你出轨对象的朋友,也不要把你的朋友介绍给出轨对象!越形成交叉的小团体,越容易进入抖音算法的舒适区。
相反,你倒是可以去混入更多高纯度的垂直小圈子,用更成建制的小团体烙印冲淡原有特征,混淆抖音对你社交圈层的判断——当然,代价就是你的推荐视频也会变得相当难看。
② 高纯度路线
如果你的多跳用户中,有一个关注和粉丝都极多的交际花账号,是否就会让你的社交关系变得足够隐蔽?
当然不会。
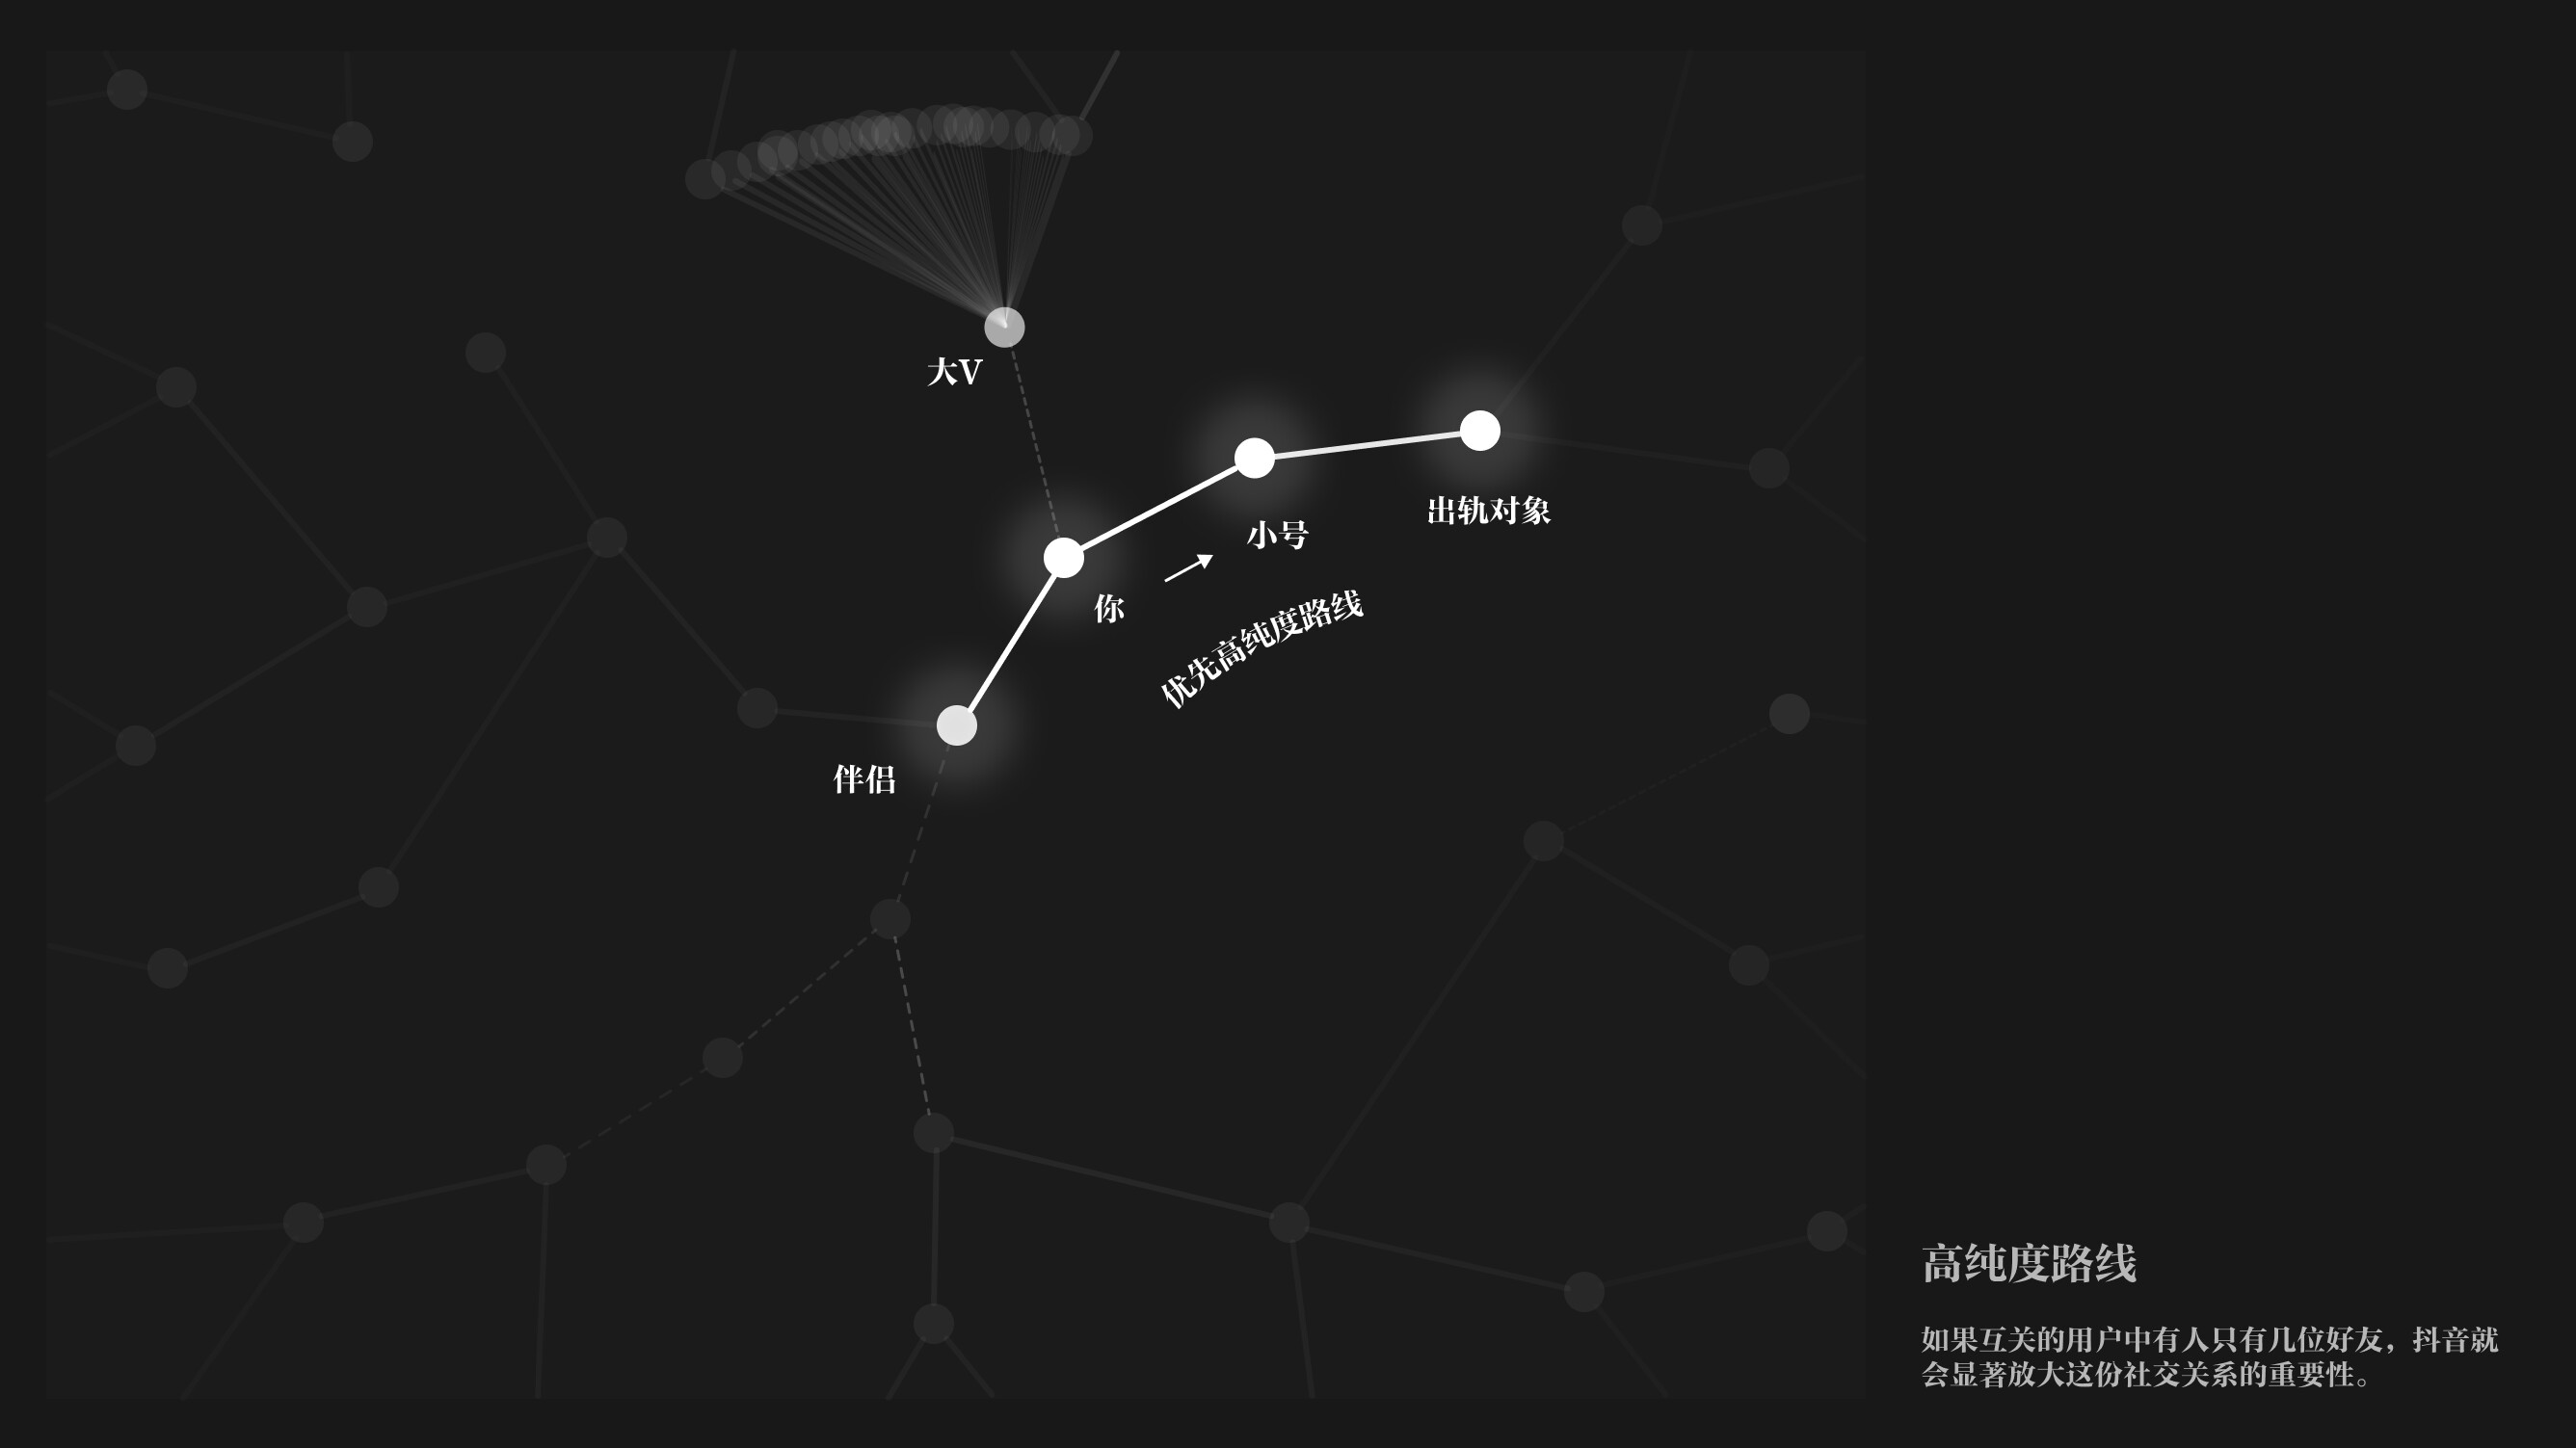
模型在提炼你的社交向量时,会过滤你的邻居们和你无关的特性 [13]
,抖音特有的机制,还会使得模型偏爱那些粉丝数量相对较低的邻居 [14]
,认为他们更能代表你的社交圈。
当你和大 V 互关时,抖音会显著地降低这个人对你社交向量的影响——就像你关注的明星、主播,他们庞大的粉丝实际上都和你是好友的概率并不大。
但鸡贼的是,如果你互关的用户中有人只有几位好友,抖音就会显著放大这份社交关系的重要性。
因此,如果你开个小号去联系你的出轨对象——因为设备、网络、地理位置等等的一致性,你的大号和小号必然被绑定为 1 跳邻居,而小号唯一关注的出轨对象,权重就会被极度放大,让你的伴侣刷到的概率几乎就是 100%。
所以… 要不等你成为大 V 后,再去出轨?
③ 安全边界区
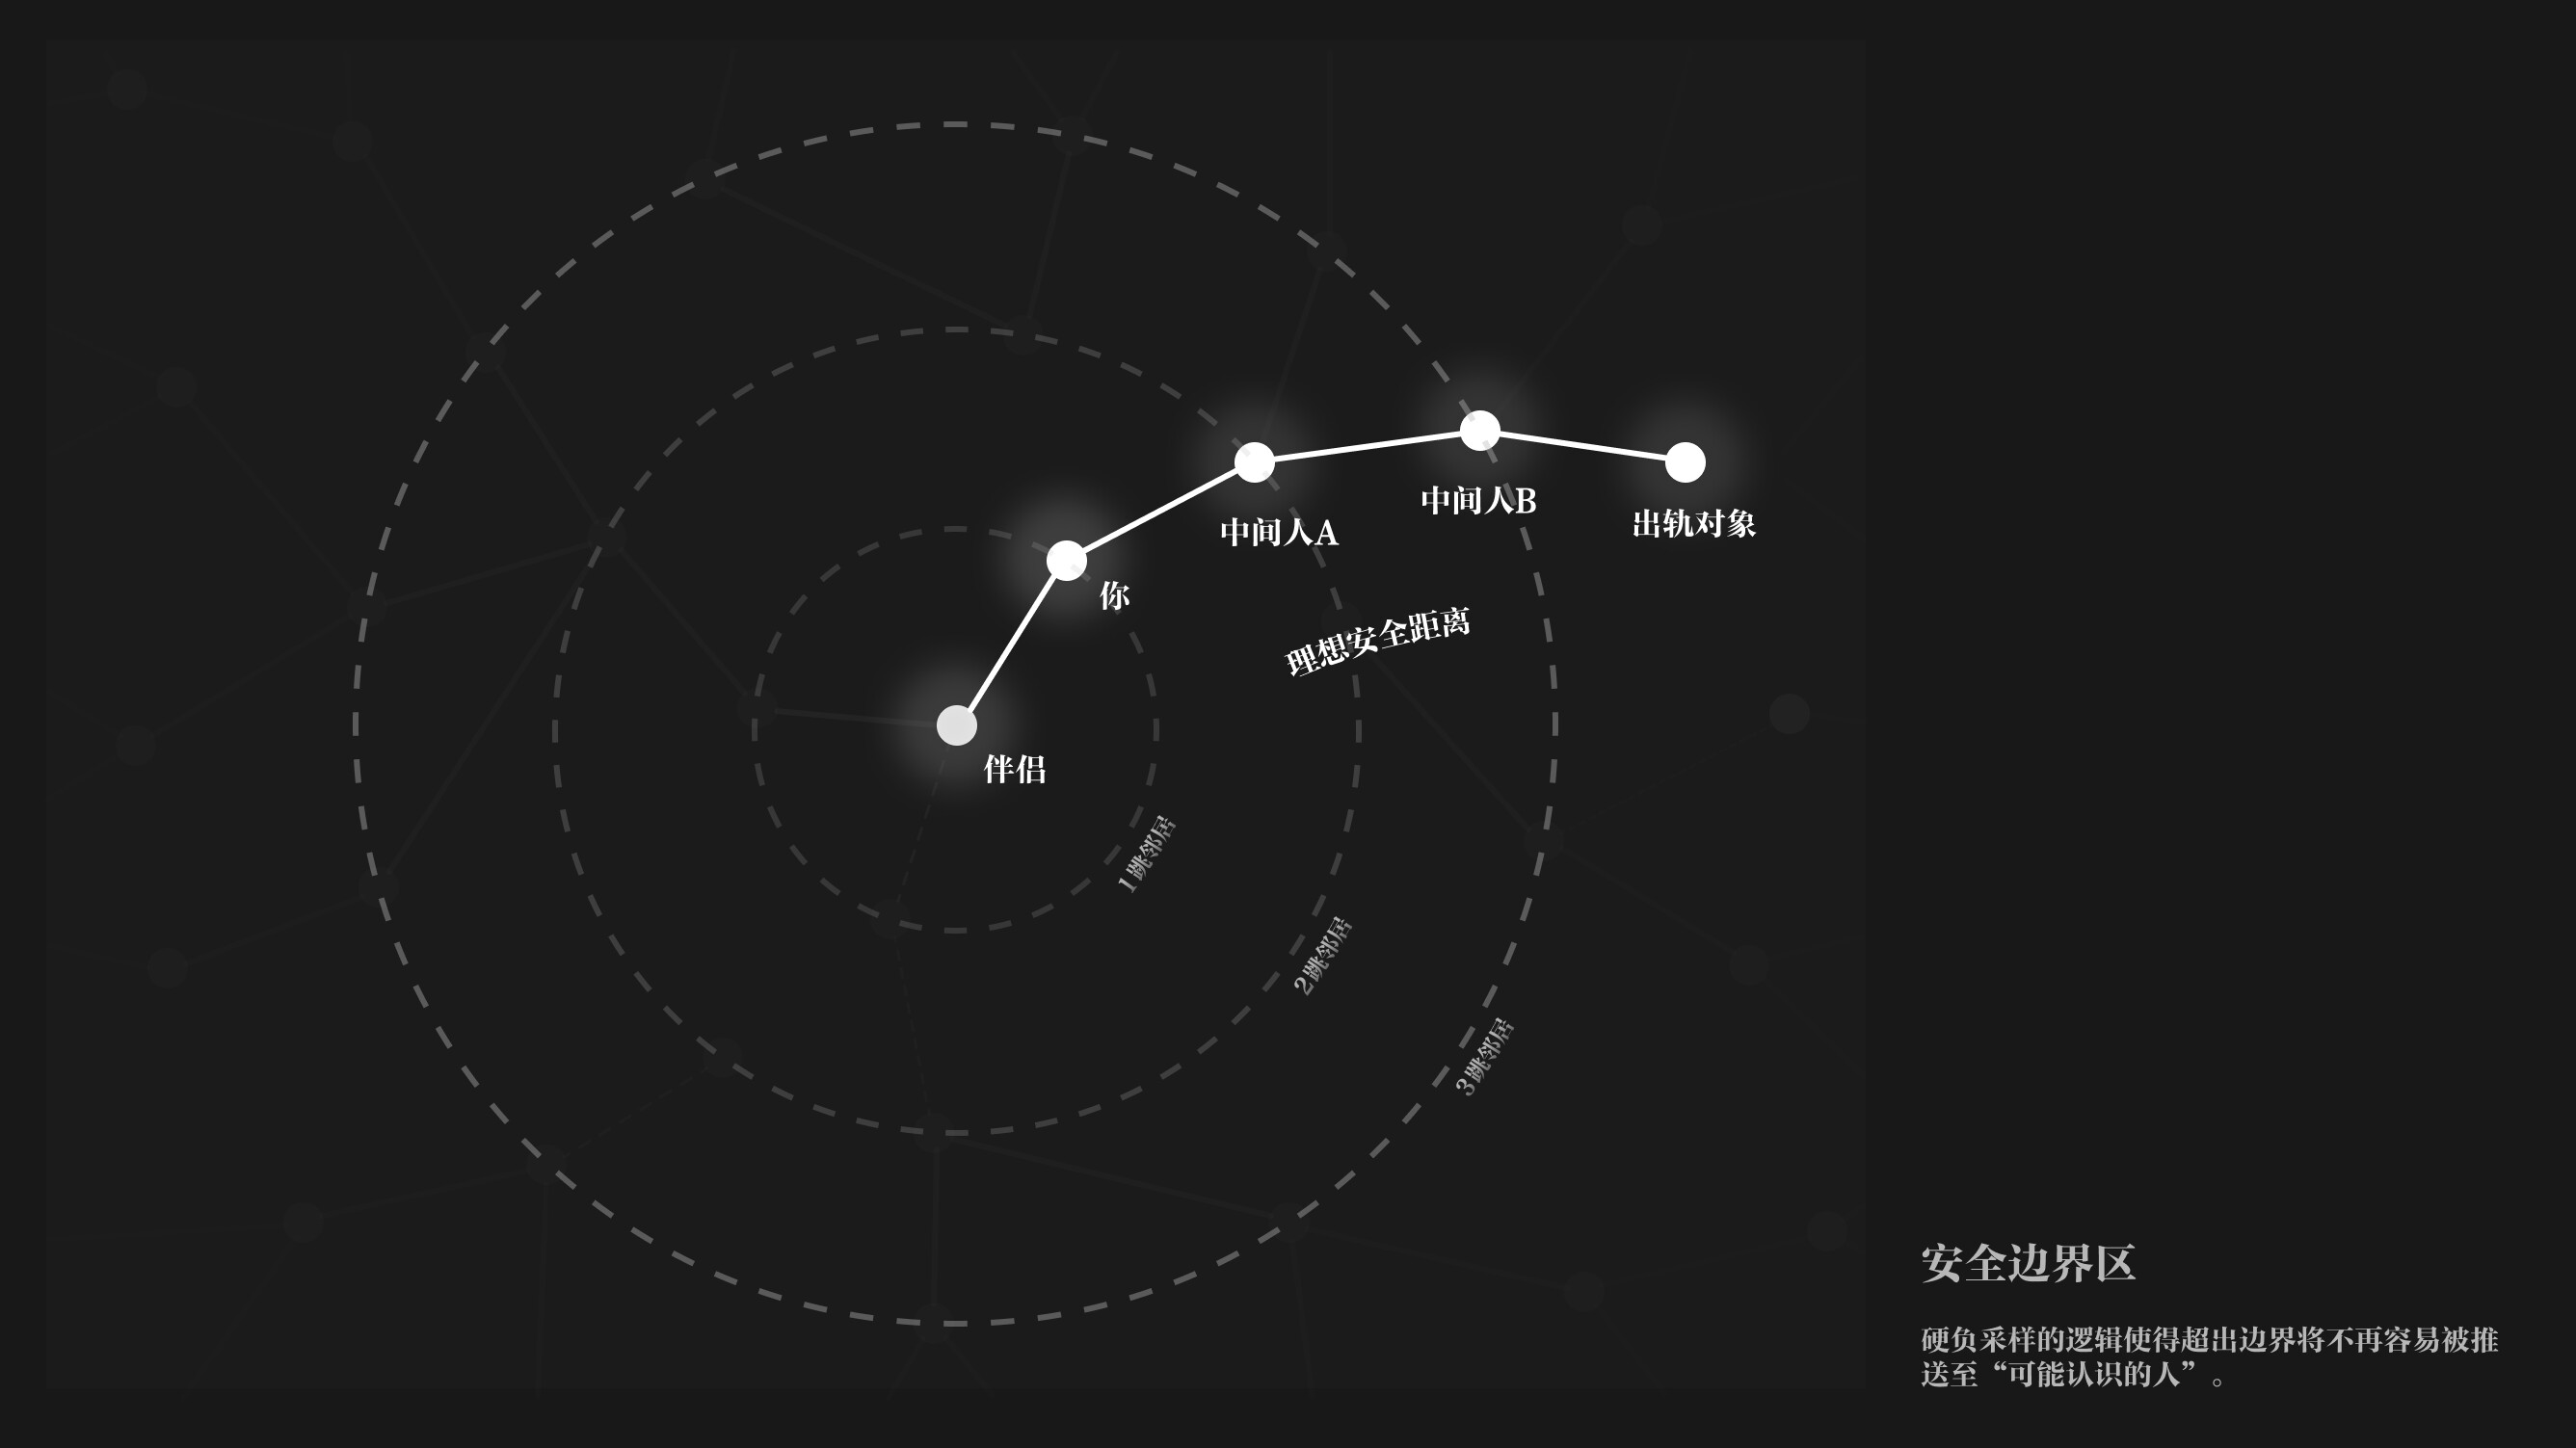
为了提升分辨力,模型在训练时还抓取了和用户有微弱关联但不是好友的反面样本进行训练,以便准确地剔除和你有关联但你真不认识的人。这些反面样本,都来自 4-5 跳位置的节点 [17]
。
这意味着,如果出轨对象在你伴侣的 1-3 跳以内,抖音就会拼命想办法往你伴侣脸上推;
但一旦出轨对象处于你伴侣 4-5 跳的位置上,抖音就会灯下黑地雪藏你的出轨对象。
现在你有了一个好消息和一个坏消息。
好消息:理论上如果你能在你和你的出轨对象间,垫上 2-3 个毫无关联的阻断层,那你就能让你的伴侣永远刷不到你的出轨对象!
坏消息:现实中几乎无法做到。中间的工具人,只要你们互动,就有概率会让你们形成一个小团体,被一起打包曝光在你伴侣的推荐视频里。
凭借这几个特点,这个模型提炼用户的社交坐标越来越准确。那它究竟多久提炼一次呢?
在 21-22 年的时候,抖音每天要吞吐至少 6.5 亿份样本;在 2 亿多节点的图上跑一轮传统的 CPU 图神经网络训练需要 10 小时 [18]
。那时候,你上午出完轨,你的伴侣要到下午才能刷到你出轨对象的视频。
但在这几年,抖音不仅用 GPU 在线随机游走采样把原本 3.5 小时的全图采样硬生生压到了 13 分钟 [19]
,还升级了在线流式训练底座,每隔几分钟就向线上增量同步一次变动数据 [20]
——现在你在酒店房间点开出轨对象刚拍的视频,几分钟后你的伴侣就可以在客厅里刷到它!
不过,在最终处刑前,还有一次机会。
早些年,像 SAC 这样的图模型算完你的社交坐标后,是作为静态特征交给双塔系统的;但这几年,抖音更进一步搞出了 “端到端联合训练(E2E-GRec)”——把图神经网络和视频推荐排序焊死在了一条流水线上。
这导致了,抖音并不会毫无节制地猛推你的出轨对象的视频。如果第一次推荐,你的伴侣不感兴趣(低停留时长),抖音就会降级视频的推荐权重 [21]
。等到下一次你们高频互动时,才会再继续提高权重进行推送。多次都被快速划过后,抖音就会最终停止推送。
只要视频里没有车窗玻璃的反射、不锈钢碗上的倒影、和你家里同款的衣服… 这一切都将极其成功。
恭喜你,到现在已经完全了解抖音的 PYMK 机制。
但朋友,如果你问我究竟有没有什么好办法让伴侣不要刷到出轨对象的视频?
唉:
用抖音不出轨,出轨不要用抖音啊!
参考
-
2022-ByteGNN: Efficient Graph Neural Network Training at Large Scale https://www.vldb.org/pvldb/vol15/p1228-zheng.pdf
-
2025-Efficient Graph Data Access for Out-of-Memory GPU Streaming Graph Processing https://www.vldb.org/pvldb/vol18/p3854-wang.pdf
-
2022-ByteGraph: A High-Performance Distributed Graph Database in ByteDance https://www.vldb.org/pvldb/vol15/p3306-li.pdf
-
2022-Spatial Autoregressive Coding for Graph Neural Recommendation https://arxiv.org/abs/2205.09489
-
2024-BG3: A Cost Effective and I/O Efficient Graph Database in ByteDance https://dl.acm.org/doi/pdf/10.1145/3626246.3653373
-
2026-ByteGraph-Dione: An Adaptive Dual-Format Graph Engine with Hotspot Awareness and Transaction Efficiency for Production-Scale Workloads https://dl.acm.org/doi/pdf/10.1145/3788853.3803073
-
连接两个用户的 “边”,明确包含了共同点赞(co-liking)和共同收藏(co-favoring)- FlowWalker
-
2025-E2E-GRec: An End-to-End Joint Training Framework for Graph Neural Networks and Recommender Systems https://arxiv.org/pdf/2511.20564.pdf
-
基于 Swing 算法:共同互动的视频越冷门、用户平时越不乱点赞,算出的共同行为权重越高 - E2E-GRec
2025-E2E-GRec: An End-to-End Joint Training Framework for Graph Neural Networks and Recommender Systems [https://arxiv.org/pdf/2511.20564](https://arxiv.org/pdf/2511.20564)
消融实验证明 - SAC
实测表明堆叠 2 层效果最好 - SAC
NIB 邻居信息瓶颈 - SAC
游走转移概率公式中,所有邻居总和越多,越难继续被游走踩中 - FlowWalker
优先从邻居少的节点出发的查询优化器 CBO - ByteGraph
LightGCN 对称归一化公式,节点的度数全都在分母上 - E2E-GRec
二阶随机游走的硬负采样 - SAC
2024-GraphScale: A Framework to Enable Machine Learning over Billion-node Graphs [https://arxiv.org/pdf/2407.15452](https://arxiv.org/pdf/2407.15452)
在 2.27 亿用户、27.1 亿边的抖音好友推荐图上,耗时优化 - FlowWalker
2022-Monolith: Real Time Recommendation System With Collisionless Embedding Table [https://arxiv.org/pdf/2209.07663](https://arxiv.org/pdf/2209.07663)
停留时长、跳过等负反馈,直接反向传播至底层 GNN 参数 - E2E-GRec
抖音用的是 QQ 小号登陆的,小号没有加任何人。
没有用任何手机号登陆,也没有允许它读取我的通讯录。
我都做到这份儿上了~
最后还是在可能认识的人里,发现了同学的同学,大学的校友。
经过多方面查证,发现……
我抖音,关注了我的大学舍友,我的大学舍友关注了她的朋友~
所以可能这样抖音就认为我和她的朋友是认识的吧。╮(╯▽╰)╭
华为云开发者联盟
你老死不相往来的 EX,早已记不起相貌的初中同学、前同事、甚至你最不想见到的人——你的 BOSS,这些人是怎么出现在你社交软件推荐用户的名单里的呢?这其中关键技术便是:知识库的链接预测,又称为知识图谱补全。
众里寻他千百度,蓦然回首,那人却在推荐名单处。
社交软件最牛的地方之一, 一定是用户关系的深度挖掘。明明你已经拉黑了某些人的电话、微信、以及所有社交账号,但 TA 还是毫不例外地出现在页面上 “你可能认识的人” 里。这些人包括你老死不相往来的 EX,早已记不起相貌的初中同学、前同事、甚至你最不想见到的人——你的 BOSS。
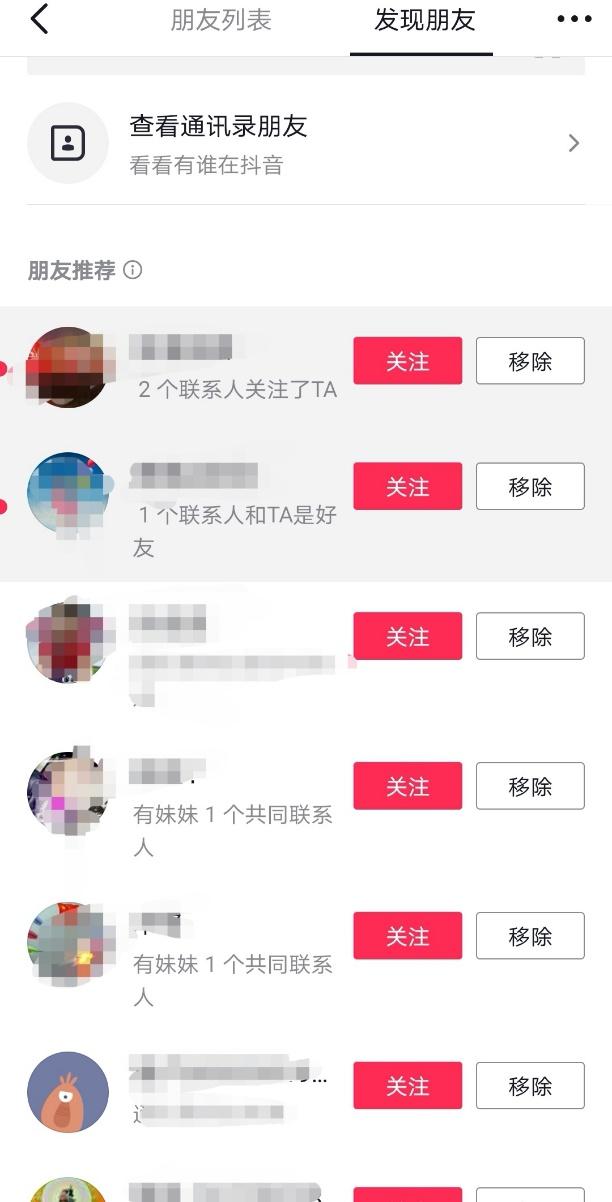
▲抖音 - 发现朋友
那么,这些人是怎么出现在你的名单里的呢?
这其中关键技术便是:知识库的链接预测,又称为知识图谱补全。
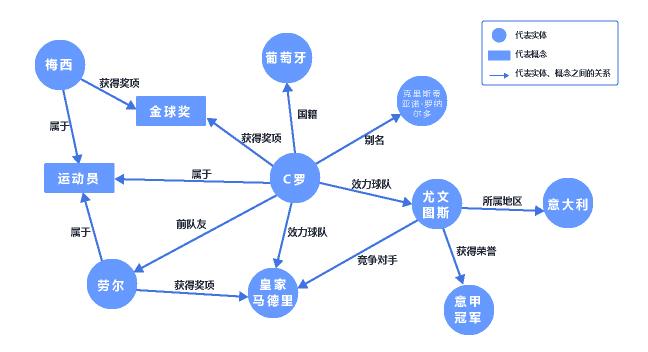
一图理解什么是知识图谱?
知识图谱是一种将知识写成结构化三元组的多关系图,包含了实体、概念和关系。
实体指的是现实世界中的事物比如人名、地名、机构等。**概念指的是具有同种特性的实体构成的集合,**如下图中的 “运动员”、“金球奖” 等。关系则用来表达不同实体之间的某种联系。
知识图谱用实体和关系组成图谱,为真实世界的各个场景直观建模。构建知识图谱的过程本质是建立认知、理解世界的过程。
如何进行知识图谱补全
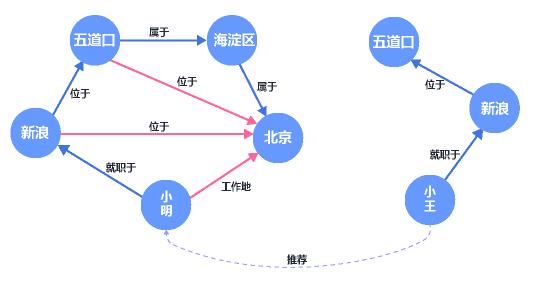
以小明为例,小明就职于位于五道口的新浪,系统可以推测出小明在北京工作。并将同样在北京新浪工作的小王推荐给了他。在下图中,蓝色的箭头表示表示已存在的关系,红色箭头为知识图谱补全后的关系。
知识图谱与知识表示学习的关系
知识图谱是由实体和关系组成,通常采用三元组的形式表示——head(头实体),relation(实体的关系),tail(尾实体),简写为 (h,r,t)。知识表示学习任务就是学习 h,r,t 的分布式表示(也被叫做知识图谱的嵌入表示 (embedding))。可以这么说,有了知识图谱的 Embedding,AI 式的知识图谱应用才成为可能。
如何理解嵌入表示 Embedding?
简单来说,embedding 是对一个对象(词、字、句子、文章…)在多个维度上的描述,相当于通过数据建模的方法来描述一个对象。
举个例子,我们经常用到的 Photoshop 里关于颜色的 RGB 表示法就属于一种非典型的 embedding。在这里颜色被拆成三个特征纬度,R(红色强度,取值范围 0-255),G(绿色强度,取值范围 0-255),B(蓝色强度,取值范围 0-255)。RGB(0,0,0) 就是黑色。RGB(41,36,33) 就是象牙黑。通过这样的方法,我们可以通过数字来描述颜色。
!(data:image/svg+xml;utf8,)
知识表示学习都有哪些方法
知识表示学习的关键是设计合理的得分函数,在给定事实三元组为真的情况下我们希望最大化得分函数。它从实现形式上可分为以下两类:
基于结构的方法
该类模型的基本思想是从三元组的结构出发学习知识图谱的实体和联系的表示,其中最为经典的算法是 TransE 模型。该方法的基本想法是头向量表示 h 与关系向量表示 r 之和与尾向量表示 t 越接近越好,即 h+r≈t。这里的 “接近” 可以使用 L1 或 L2 范数进行衡量。原理图如下:
!(data:image/svg+xml;utf8,)
该类知识表示学习模型还有:TransH, TransR, TransD,TransA 等。
基于语义的方法
这类模型是从文本语义角度出发学习 KG 的实体和关系的表示。这类表示方法主要有 LFM, DistMult, ComplEx, ANALOGY, ConvE 等。
知识表示学习的应用
由于基于表示学习,可以将知识图谱的实体和关系进行向量化表示,方便后续下游任务的计算,典型应用有以下几种:
**1)相似度计算:**利用实体的分布式表示,我们可以快速计算实体间的语义相似度,这对于自然语言处理和信息检索的很多任务具有重要意义。
如何进行相似度计算呢?举个例子。
假设 “李白” 这个词的 embedding 一共是 5 维,其值为 [0.3, 0.5, 0.7, 0.03, 0.02],其中每个维度代表和某个事物的相关性,这五个数值分别代表[诗人, 作家, 文学家, 自由职业者, 侠士] 的含义。
而 “王维”=[0.3, 0.55, 0.7, 0.03, 0.02],“牛顿”=[0.01, 0.02, 0.06, 0.4, 0.01],我们可以用余弦距离(几何中,夹角余弦可用来衡量两个向量方向的差异;机器学习中,借用这一概念来衡量样本向量之间的差异。)来计算这几个词的距离,显而易见李白和王维的距离更近,和牛顿的距离更远。 由此可以判断 “李白” 和“王维” 更为相似。
**2)知识图谱补全。**构建大规模知识图谱,需要不断补充实体间的关系。利用知识表示学习模型,可以预测 2 个实体的关系,这一般称为知识库的链接预测,又称为知识图谱补全。上文中 “五道口小明” 的例子可以很好的解释。
**3)其他应用。**知识表示学习已被广泛用于关系抽取、自动问答、实体链接等任务,展现出巨大的应用潜力。
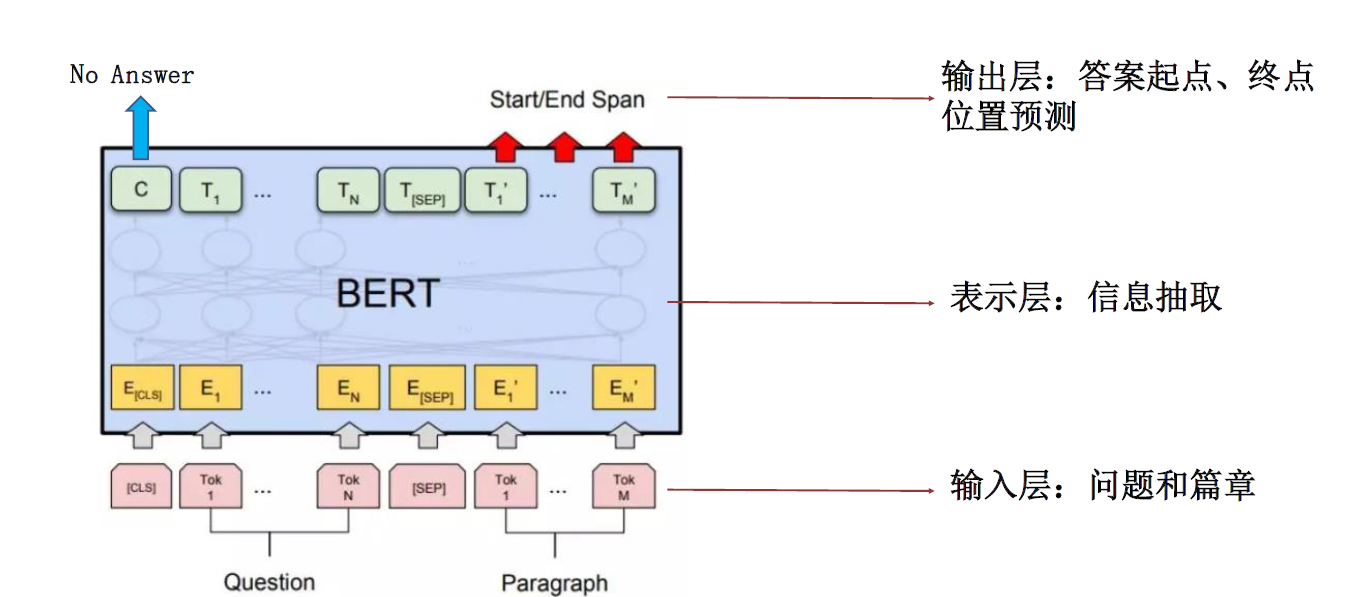
自动问答是与知识表示学习深度结合的一大应用。对于智能问答产品来说,后台设计时,一般分为 3 层,输入层、表示层、输出层。输入层简而言之就是问题库,这里集合了所有用户可能会问到的问题。再经过表示层的知识抽取,最终返回结果。
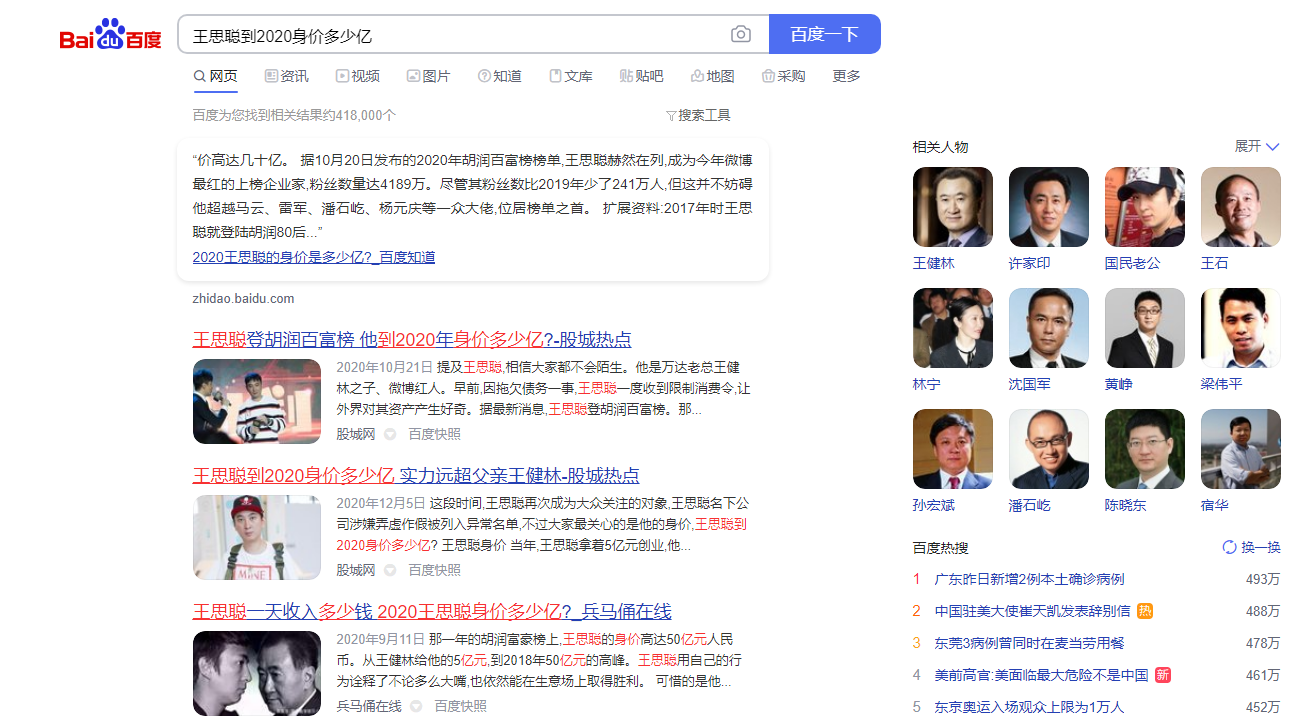
典型的智能问答产品有苹果 Siri、微软小冰、百度、阿里小蜜等。这些问答产品的一大特色是,可以使搜索结果更精准,而不是返回一堆相似的页面让你自己去筛选,达到 “所答即所问”。比如,搜索 “王思聪的身价多少”,返回来的结果就是具体的数字。
总结
简而言之,社交产品基于知识图谱知识补全技术,通过实体和关系的表示对缺失三元组进行预测,在已知头实体以及头实体间的关系,预测其尾实体。也就是说,它们是根据用户画像来进行朋友推荐的,如果你不想那些 “老熟人” 出现在你的推荐名单里,最好的方法是,关掉社交产品上的地理定位、尽可能少地透露个人信息。
参考资料
1、刘知远, 孙茂松, 林衍凯, 谢若冰《知识表示学习研究进展》